Résumer le contenu avec:




Un interlocuteur ajoute une précision alors que votre assistant IA est déjà en train de répondre : « Le jeudi me convient. Mais seulement après 15 heures. » Une conversation de qualité prend en compte ce détail et poursuit son cours. C'est précisément l'objectif du Full Duplex (Beta) dans Famulor : l'assistant peut écouter et parler en même temps, adaptant sa réponse en cours aux nouvelles informations.
Cette mise à jour ajoute un nouveau mode de conversation à Realtime. Vous choisissez où l'utiliser. Les assistants existants conservent leurs moteurs et leurs paramètres. Ce guide compare le Full Duplex avec les modes Pipeline, Half Cascade et Realtime standard, explique les benchmarks des modèles pertinents et montre comment évaluer les options pour vos propres appelants.
Informations sur le produit et les sources vérifiées le 13 septembre 2026. Les chiffres ci-dessous proviennent d'évaluations publiées par les fournisseurs et de benchmarks externes. Les dialogues professionnels sont des exemples illustratifs.
Écouter une conversation en Full Duplex
Cette démonstration Famulor présente une conversation en milieu professionnel avec des questions de suivi et des recherches d'informations, incluant des tâches et des mises à jour de produits. Elle illustre le flux entre le dialogue et la récupération de données. Il ne s'agit pas d'un benchmark de réussite des appels clients entrants. La conversation est en allemand.
Démonstration Famulor : questions de suivi et recherches d'informations en conversation. YouTube
Quatre chemins de conversation, côte à côte
Pipeline, Half Cascade et Realtime décrivent différentes manières de transformer la parole en réponse. Dans Famulor, le Full Duplex est une variante du moteur Realtime. Comparer quatre chemins de conversation facilite la compréhension des choix pratiques.
Chemin de conversation | Traitement | Voix | Priorité typique |
|---|---|---|---|
Pipeline | Audio → STT → modèle texte → TTS | Voix TTS séparée | Workflows structurés et sélection indépendante des composants |
Half Cascade | Audio → modèle Realtime → texte → TTS | Voix TTS séparée | Entrée audio avec une voix de sortie indépendante |
Standard Realtime | Audio → modèle vocal natif → audio | Voix du modèle natif | Conversations directes de la parole à la parole |
Realtime : Full Duplex (Beta) | Réception et production audio, y compris simultanément | Voix de conversation native compatible | Dialogues avec ajouts et prise de parole dynamique |
Pipeline : Un service de reconnaissance vocale transforme l'audio en texte. Un modèle de langage traite le texte et un service de synthèse vocale (TTS) distinct énonce la réponse. Vous pouvez choisir la reconnaissance, le raisonnement et la voix séparément. Le streaming peut rendre cette architecture réactive ; son nom seul ne détermine pas un temps de réponse fixe.
Half Cascade : Un modèle Realtime traite l'audio entrant et produit un texte de réponse. Un service TTS séparé énonce ce texte. Cela combine une entrée audio directe avec une voix de sortie sélectionnée indépendamment. Il n'ajoute pas l'étape STT amont séparée que l'on trouve dans un pipeline classique.
Standard Realtime : Le modèle traite et génère l'audio nativement. L'écoute, la génération de réponse et la voix sont plus étroitement connectées. La gestion des pauses et le comportement en cas d'interruption dépendent du modèle et de la configuration spécifiques.
Realtime avec Full Duplex : La parole entrante et sortante peut être traitée conjointement dans le cadre du dialogue en cours. L'assistant peut entendre un ajout pendant qu'il parle. Ce mode utilise une voix de conversation native compatible.
Interrompre la lecture et écouter tout en parlant sont des capacités différentes
De nombreux assistants vocaux prennent déjà en charge le barge-in : ils arrêtent la lecture lorsque l'appelant commence à parler. C'est utile. Mais « oui, exactement » et « non, l'autre adresse » nécessitent des réactions différentes. L'un est un bref accusé de réception ; l'autre modifie les informations que l'assistant doit utiliser.
Le Full Duplex vise un échange plus flexible. L'assistant doit interpréter une contribution dans son contexte et répondre de manière appropriée. Testez cela avec des phrases que vos appelants utilisent réellement : brefs accusés de réception, ajouts plus longs, détails auto-corrigés et parole avec bruit de fond.
Ce qui compte pour l'appelant, c'est l'expérience globale. L'assistant a-t-il compris ? L'appelant a-t-il dû se répéter ? Le résultat était-il correct ? Une première syllabe rapide ne répond pas à ces trois questions.
Maintenir la conversation pendant la récupération d'informations
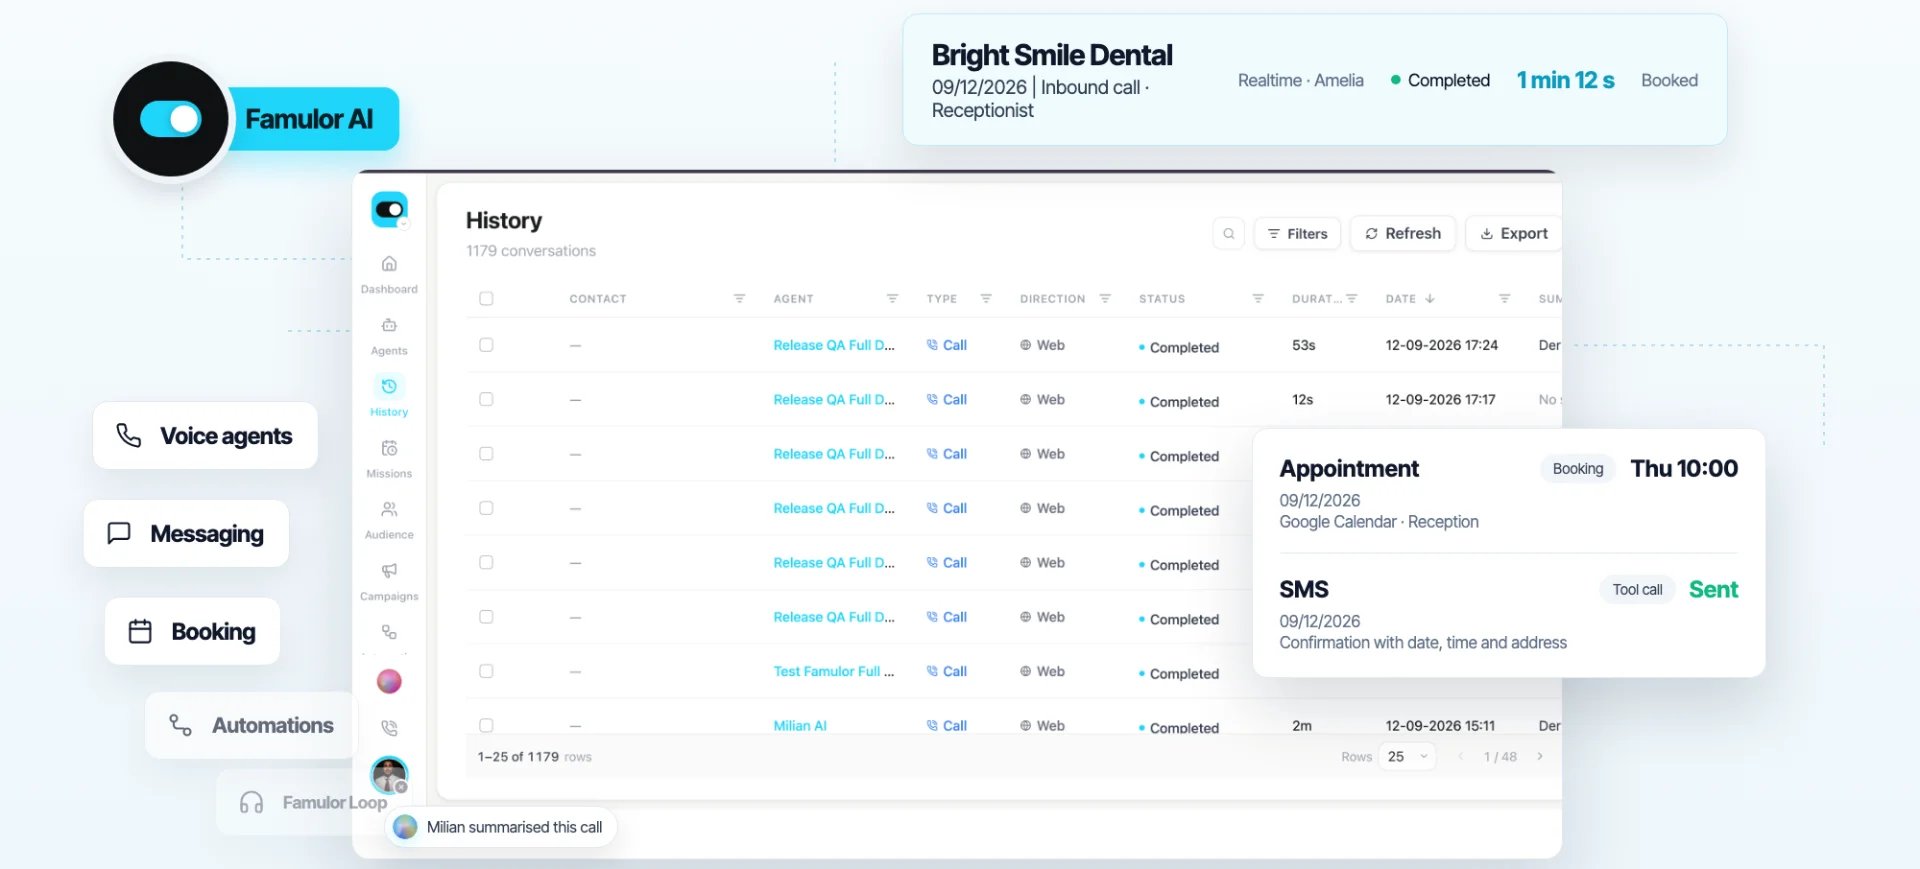
Une conversation utile nécessite parfois une action en arrière-plan. Un calendrier doit renvoyer des créneaux disponibles, un CRM doit localiser un contact ou une base de connaissances doit fournir les informations pertinentes. L'assistant doit expliquer ce qu'il fait et poursuivre avec le résultat réel.
Par exemple, l'assistant dit : « Je vérifie les rendez-vous disponibles. » L'appelant ajoute : « Seulement l'après-midi, s'il vous plaît. » Cette préférence doit orienter la recherche. Un rendez-vous ne doit être décrit comme réservé qu'une fois que le calendrier connecté l'a confirmé. Le dialogue naturel et les actions correctes doivent fonctionner de concert.
Lors de la configuration d'une action, décrivez son objectif, les entrées requises et le résultat attendu. Spécifiez quand l'assistant doit poser une question de suivi. Pour les outils de calendrier, distinguez la recherche de disponibilité de la création d'une réservation confirmée. Un accusé de réception amical ne doit jamais remplacer une réponse système réussie.
GPT-Live et Realtime : résultats de benchmarks publiés
OpenAI a présenté GPT-Live-1 le 10 septembre 2026. Ces chiffres proviennent des graphiques de l'annonce originale de GPT-Live-1. Ils comparent des configurations de modèles spécifiques.
Benchmark | GPT-Live-1 | GPT-Realtime-2.1 | GPT-Realtime-2 |
|---|---|---|---|
Tau3 (Voix), Pass@1 | 86,2 % | 45,7 % | 42,4 % |
Full Duplex Bench v1.5 : interactivité | 80,1 % | 45,4 % | 47,8 % |
Full Duplex Bench v1 : latence de prise de parole | 0,798 s | 1,410 s | 1,630 s |
Full Duplex Bench v3 : Appel d'outils | 87 % | 60 % | 58 % |
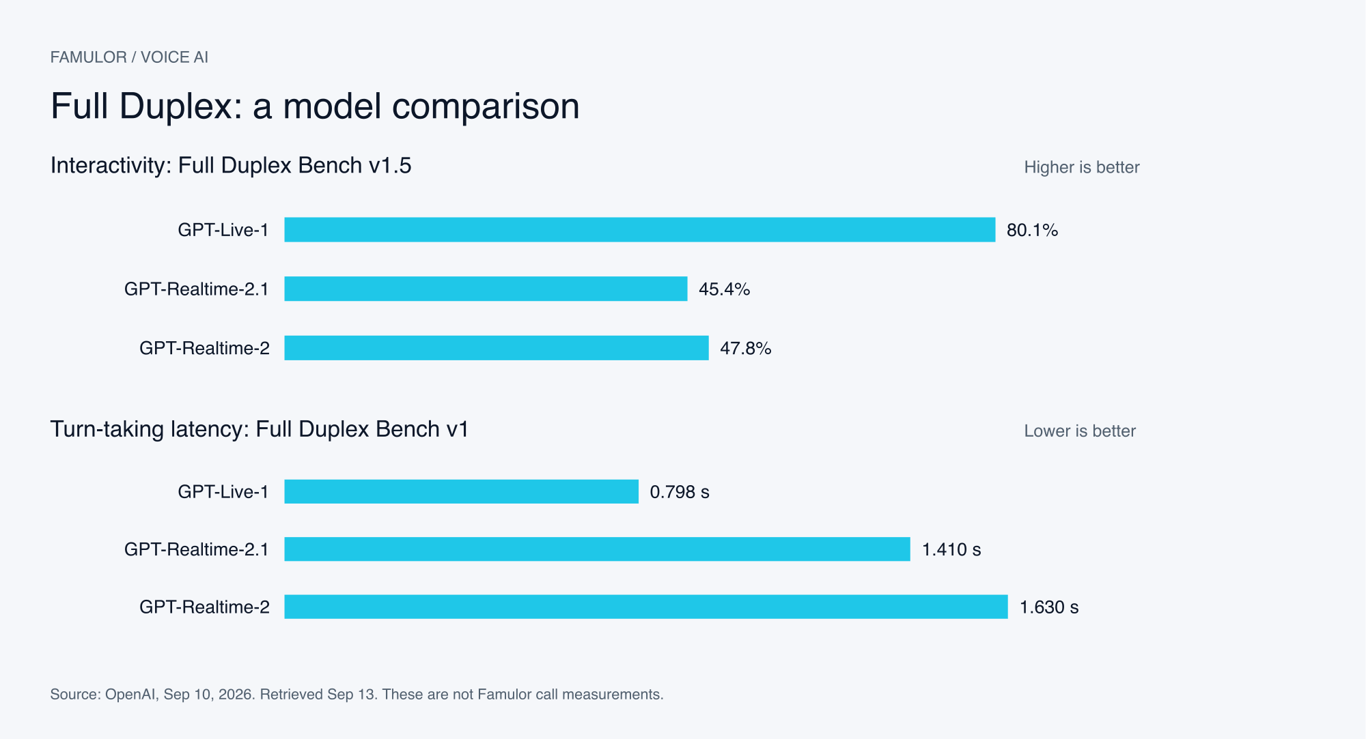
Graphique Famulor utilisant les résultats publiés par OpenAI. Deux mesures distinctes, pas un score global.
Méthodologie : Tau3 (Voix) utilise une pondération égale des domaines. La configuration GPT-Live utilise le backend Astra en mode moyen pour ce résultat ; l'évaluation de l'appel d'outils utilise Terra en mode bas. Ces éléments décrivent les évaluations publiées, et non des configurations Famulor sélectionnables. Les lignes représentent différents tests et versions de benchmarks.
Deux questions importent indépendamment : dans quelle mesure un modèle gère-t-il une conversation dynamique, et avec quelle fiabilité accomplit-il une tâche ? L'interactivité et l'appel d'outils fournissent des signaux différents. Ces résultats ne sont ni des temps de réponse Famulor garantis, ni des prévisions pour les résultats de vos propres appels.
Une vision du marché distincte des modèles Realtime natifs
Coval évalue les modèles vocaux en utilisant sa propre configuration de conversation. Sa comparaison publiée offre une autre perspective sur les modèles audio natifs. Comme la procédure diffère, ses chiffres ne peuvent pas être directement combinés avec les résultats du Full Duplex Bench d'OpenAI.
Modèle | Latence voix-à-voix ↓ | Adhésion aux instructions ↑ | Échantillons |
|---|---|---|---|
GPT Realtime 2 | 1332 ms | 50 % | 448 |
Gemini 3.1 Flash Live (Preview) | 1340 ms | 56 % | 445 |
Source : Coval : Gemini Live et modèles de comparaison, chiffres sur 30 jours glissants ; dernière exécution listée le 27 août 2026, récupérée le 13 septembre. La ligne Gemini couvre spécifiquement la version 3.1 Flash Live Preview. Elle ne mesure pas les variantes Gemini 2.5 Native Audio également listées dans Famulor.
Une révision de modèle peut modifier un résultat. Vérifiez le nom complet du modèle, la région de test, le canal et la date. Comparer un microphone de navigateur avec un appel téléphonique peut également introduire des différences causées par le transport audio plutôt que par le modèle.
Benchmarks TTS : à quelle vitesse la voix démarre-t-elle ?
Pipeline et Half Cascade vous permettent de sélectionner la sortie vocale séparément. Le Time to First Audio, ou TTFA, aide à évaluer ce choix : combien de temps s'écoule entre la demande TTS et la première sortie audible ? La sélection suivante provient des mesures publiées par Coval.
Modèle | TTFA ↓ | WER ↓ |
|---|---|---|
Inworld TTS 2 | 177 ms | 4,6 % |
Eleven Flash v2.5 | 252 ms | 6,7 % |
Soniox TTS v2 | 255 ms | 4,0 % |
Cartesia Sonic 3.5 | 274 ms | 5,9 % |
Deepgram Aura 2 | 314 ms | 5,3 % |
Rime Coda | 316 ms | 5,0 % |
Fish Audio S2.1 Pro | 355 ms | 4,7 % |
Eleven v3 Conversational | 380 ms | 4,3 % |
Cartesia Sonic 3.6 | 451 ms | 5,3 % |
GPT-4o mini TTS | 1026 ms | 4,8 % |
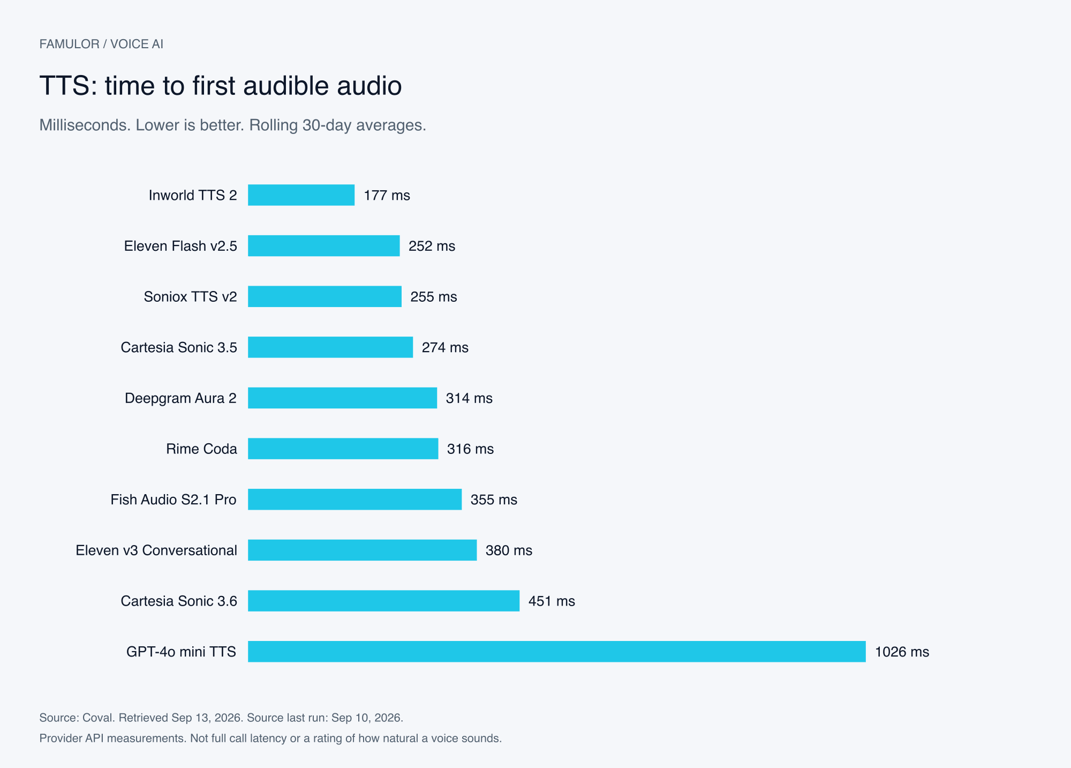
Graphique Famulor basé sur les mesures TTS de Coval. Le temps indiqué couvre la demande TTS mesurée.
Source : Comparaison des modèles TTS de Coval. Moyennes sur 30 jours glissants, récupérées le 13 septembre 2026 ; dernière exécution listée le 10 septembre. WER signifie taux d'erreur de mots. Plus le chiffre est bas, mieux c'est pour les deux colonnes. Aucune colonne n'évalue la préférence vocale personnelle ou le naturel d'une conversation complète.
Coval définit le TTFA comme le temps jusqu'à la sortie audible, incluant le silence initial. Sa méthodologie TTFA et la description du jeu de données TTS documentent un ensemble de prompts fixe et des API de fournisseurs dans une région américaine. Ces conditions diffèrent d'un appel Famulor de bout en bout.
Les chiffres des fournisseurs nécessitent également du contexte. ElevenLabs décrit environ 75 millisecondes d'inférence de modèle pour Flash dans des conditions appropriées. Sa documentation sur la latence sépare cette mesure du temps réseau et applicatif supplémentaire. Elle mesure donc quelque chose de différent des 252 millisecondes du tableau Coval.
Choisissez une voix avec un test d'écoute rapide basé sur votre activité : noms d'entreprise, noms de rues, dates, heures, adresses e-mail et une explication plus longue. Vérifiez si la sortie reste claire à mesure que le contenu devient plus complexe. Écoutez le regroupement des nombres et la prononciation des abréviations.
Le Full Duplex utilise un choix de voix différent. Sa voix de conversation native fait partie du mode. Sélectionner un fournisseur TTS autonome rapide ne transforme pas ce fournisseur en une voix Full Duplex. Si une voix TTS particulière ou une voix de marque est essentielle tout au long de la conversation, comparez également Pipeline et Half Cascade.
Benchmarks des modèles de raisonnement : résolution de tâches et utilisation d'outils
Un assistant vocal doit connecter des informations, suivre des règles et effectuer les bonnes actions. Les benchmarks de texte et d'outils aident à évaluer ces capacités. Ils mesurent des capacités différentes de la latence vocale ou de la qualité de la voix.
Une comparaison issue de la fiche technique du modèle Gemini 3.5 Flash
Modèle | MCP Atlas | Toolathlon |
|---|---|---|
Gemini 3.5 Flash | 83,6 % | 56,5 % |
GPT-5.5 | 75,3 % | 55,6 % |
Gemini 3 Flash | 62,0 % | 49,4 % |
Source : Google DeepMind : Fiche technique du modèle Gemini 3.5 Flash. Plus le chiffre est élevé, mieux c'est. Il s'agit d'évaluations des fournisseurs pour le modèle et les configurations de test indiqués, et non de mesures d'appels téléphoniques professionnels.
Modèles grands et petits sur le même benchmark de tâches
Modèle | Effort de raisonnement | Résultat ↑ |
|---|---|---|
GPT-5.4 | xhigh | 98,9 % |
GPT-5.4 mini | xhigh | 93,4 % |
GPT-5.4 nano | xhigh | 92,5 % |
GPT-5 mini | high | 74,1 % |
Source : OpenAI : GPT-5.4 mini et nano, Tau2-Bench Telecom. Plus le chiffre est élevé, mieux c'est. L'effort de raisonnement fait partie de chaque résultat ; ce n'est pas une recommandation d'utiliser ce paramètre pour chaque réponse vocale sensible au temps.
Utilisez ces chiffres pour présélectionner des candidats. Ensuite, évaluez vos tâches réelles : demander une partie manquante d'une adresse, distinguer des produits similaires ou suspendre une action lorsqu'une entrée requise est absente. Un modèle qui domine un benchmark large peut ne pas offrir la meilleure combinaison de vitesse, de coût et de qualité pour un dialogue de réception court.
Le temps de réponse du pipeline comporte plusieurs composants : détection de la fin de la parole, transcription, génération de réponse, recherche d'outils et sortie vocale. Certains travaux peuvent se chevaucher. Ajouter des chiffres provenant de classements non liés ne produit pas un benchmark de bout en bout fiable.
Six cas d'usage pour des appels plus naturels
Ces scénarios reflètent des workflows Famulor courants pour la réception, la qualification de leads, la prise de rendez-vous et le support. Les dialogues sont des exemples inventés, non des enregistrements clients publiés.
1. Réception : clarifier la demande en cours de conversation
Pendant que l'assistant explique les prochaines étapes, l'appelant ajoute : « Il s'agit de maintenance, pas d'une nouvelle installation. » L'agent intègre la clarification et demande les détails pertinents. L'équipe reçoit une demande correctement catégorisée. Le Full Duplex mérite d'être testé lorsque les ajouts sont fréquents ; le Pipeline reste une base utile pour un processus d'admission structuré.
2. Réservation : intégrer une nouvelle contrainte de temps
« Le mardi pourrait fonctionner. » Alors que la réponse commence, l'appelant ajoute : « Seulement après l'école, cependant. » L'agent demande l'heure précise et vérifie à nouveau la disponibilité. Il confirme le rendez-vous après une action de calendrier réussie. Évaluez si les préférences corrigées mènent à des réservations qui correspondent réellement aux besoins de l'appelant.
3. Ventes : ajuster la qualification lorsque la portée change
Un prospect mentionne un lieu, puis en ajoute trois autres. Cela change la solution pertinente et les questions à poser ensuite. L'agent doit combiner les nouveaux détails et envoyer des informations structurées au CRM. Le flux de conversation et la précision des données comptent tous deux dans ce workflow.
4. Support : gérer un numéro de référence corrigé
« La commande se termine par 42. Désolé, 24. » L'agent poursuit avec le numéro corrigé et confirme les correspondances sensibles avant d'agir. Le Full Duplex peut aider avec les auto-corrections, tandis que la recherche connectée doit toujours renvoyer une correspondance sans ambiguïté ou déclencher une question de suivi.
5. Service sur le terrain : capturer des détails d'accès supplémentaires
Un client décrit une panne et ajoute : « Vous ne pouvez entrer que par la cour. » L'agent inclut le détail dans la demande de service. Des règles métier claires déterminent quelles informations capturer et quand passer la main à l'équipe. Le mode de conversation prend en charge ces règles ; il ne les définit pas.
6. Voix de marque : choisir le bon équilibre
Une entreprise utilise une voix TTS particulière pour le contact client. Half Cascade peut combiner une entrée audio directe avec cette sortie vocale séparée. Si des ajouts fréquents façonnent les appels, testez également le Full Duplex avec une voix native. Utilisez un contenu identique et évaluez séparément la clarté, la reconnaissance de la marque et le flux conversationnel.
Configurer le Full Duplex dans Famulor
Ouvrez l'assistant concerné. Dans un espace de travail éligible avec les fonctionnalités bêta activées, sélectionnez Realtime → Full Duplex (Beta).
Écoutez les aperçus de voix natives. Choisissez une voix compatible en utilisant le vocabulaire de votre workflow. Les aperçus Full Duplex utilisent la voix de conversation réelle.
Examinez les salutations et les annonces. Vérifiez l'ouverture, le message de consentement et les annonces d'outils. Une salutation téléchargée conserve sa voix enregistrée.
Définissez les actions clairement. Spécifiez les entrées requises, les questions de suivi et les résultats infructueux. Les confirmations vocales doivent refléter les résultats réussis des outils.
Testez via le canal de contact prévu. Incluez les interruptions, les brefs accusés de réception, les détails corrigés, le silence et la fin de la conversation. Réutilisez les scénarios que vous exécutez avec votre assistant existant.
La mise à jour améliore également le démarrage avec des instructions d'assistant plus longues, la reconnaissance des actions configurées et l'enregistrement cohérent de l'utilisation de la conversation. Raccrocher après l'au revoir n'ouvre plus une nouvelle connexion vocale inutile.
Annonces naturelles et libellés requis
La voix native compatible est utilisée pour les conversations Full Duplex et les annonces destinées à ce mode. Les annonces ordinaires peuvent être reformulées en conversation. Les annonces de consentement requises sont vérifiées et lues complètement avant que le consentement ne soit accepté. Testez ce flux avec vos libellés réels et vos actions activées.
L'éditeur conserve une voix de secours et explique les conflits avec les filtres de sortie avant de basculer. Examinez les conseils de l'éditeur avant d'enregistrer la configuration afin que la nouvelle voix de conversation corresponde à votre workflow existant.
Construire une comparaison utile pour votre entreprise
Une comparaison significative utilise les mêmes tâches dans des conditions similaires. Par exemple, commencez par 20 à 30 cas de dialogue représentatifs, répétez chacun d'eux et alternez l'ordre des configurations. Il s'agit d'un point de départ suggéré pour votre évaluation, et non d'une série de tests menée pour cet article.
Enregistrez les conditions : langue, canal téléphonique ou web, région, bruit de fond, voix, version du modèle, prompt et outils connectés.
Mesurez le flux de conversation : temps jusqu'à une réponse audible, réactions aux corrections, interruptions inutiles et questions répétées. Séparez le comportement médian des cas plus lents.
Vérifiez le résultat : le bon rendez-vous a-t-il été créé ? Les champs CRM sont-ils précis ? L'assistant a-t-il expliqué honnêtement une action échouée ?
Écoutez la sortie : évaluez la clarté, la prononciation et l'adéquation à la marque. Un pourcentage ne peut pas remplacer ce test d'écoute.
Documentez également les cas où une configuration plus simple est plus performante. Un appel d'admission court peut avoir des priorités différentes d'une conversation de conseil avec des ajouts fréquents. Choisissez la configuration qui correspond au workflow et au résultat dont vous avez besoin.
Questions fréquemment posées
Qui peut sélectionner le Full Duplex (Beta) ?
L'option apparaît dans les espaces de travail éligibles avec les fonctionnalités bêta activées, un accès Realtime approprié et une région prise en charge. Au moment de la rédaction, les espaces de travail mondiaux et américains sont pris en charge ; l'option n'est pas encore disponible pour les espaces de travail de l'UE. Votre éditeur affiche les options disponibles pour votre espace de travail.
Les assistants existants basculeront-ils automatiquement ?
Non. Les assistants existants conservent leurs moteurs et leurs paramètres. Vous choisissez quels assistants utilisent le nouveau mode.
Puis-je conserver ma voix TTS existante ?
La conversation Full Duplex en cours utilise une voix native compatible. Les salutations téléchargées conservent leurs voix enregistrées. Si une voix TTS autonome particulière doit énoncer tout le dialogue, comparez Pipeline et Half Cascade.
Le Full Duplex est-il toujours plus rapide ?
Les tests publiés montrent des avantages pour certaines configurations. Le temps de réponse réel dépend également de votre canal, de votre région, de votre prompt, de vos outils et de votre conversation. Utilisez les benchmarks pour présélectionner les options et votre propre workflow pour décider.
Combien coûte le nouveau mode ?
Vérifiez les conditions actuelles et les informations d'utilisation dans votre espace de travail Famulor. Les prix des modèles externes et les timings des benchmarks ne fournissent pas un calcul de coût fiable pour un appel Famulor complet.
Commencez avec un workflow que vous connaissez bien
Choisissez un assistant avec une tâche claire : capturer une demande, trouver un rendez-vous ou classer un problème de support. Comparez son chemin de conversation existant avec le Full Duplex en utilisant les mêmes scénarios. Cela montrera où écouter et parler ensemble aide vos appelants.
La vidéo de présentation du Full Duplex de Famulor. YouTube
Ouvrez Famulor et vérifiez le Full Duplex (Beta) dans votre assistant. Trouvez plus de mises à jour de produits sur le blog Famulor.
Rédacteur chez Famulor