Inhoud samenvatten met:



Famulor Research · oktober 2026 · Gemeten 13 oktober 2026 · Bewerkt 14 oktober 2026
Een voice-agent moet de juiste actie ondernemen en deze helder bevestigen. Snelle spraakgeneratie is slechts een deel van die taak. Deze Famulor-studie vergelijkt individuele modellen, complete gespreksconfiguraties en de audio die de beller ontvangt. Je krijgt de volledige resultattabellen, relatieve kostenbanden en een acceptatieplan dat je kunt toepassen op je eigen workflows.
Inhoud van de studie
1. De bevindingen die ertoe doen
Alle negen geteste pipeline-configuraties slaagden voor acht van de acht fictieve ontvangst- en gesproken-feitcontroles. Met Gemma 4 en Soniox-herkenning constant gehouden, varieerde hun geobserveerde P50 voor het begin van de bevestiging van 1.167 tot 1.580 ms. Gradium, Deepgram, Cartesia en ElevenLabs vormen een snelle initiële shortlist. De andere vijf pipelines voltooiden eveneens de gecontroleerde taken.
Gemma 4 31B IT slaagde voor alle 16 korte, gestructureerde beslissingscontroles, met een mediane tijd voor het eerste teksttoken van 162 ms. Veel andere LLM's slaagden ook voor 16/16. De timing beschrijft dit specifieke profiel. Het stelt geen universele intelligentie- of kwaliteitsranglijst vast.
Resultaten van spraakherkenning verschillen per taal. Scribe v2 Realtime maakte, in een afzonderlijk gelabelde hercontrole, één wijziging op 161 Duitse referentiewoorden. Drie AssemblyAI Pro-configuraties en Cartesia Ink 2 maakten elk drie wijzigingen op 124 Engelse woorden. Een paar woorden kunnen de volgorde in zo'n kleine corpus veranderen.
Voor native realtime-modellen is tool-continuïteit een cruciale controle. GPT Realtime 2.1 slaagde voor de acht servicetaken. Andere configuraties vertoonden ontbrekende gesproken bevestigingen, onvoltooide suites of onopgelost protocolgedrag. Deze bevindingen zijn van toepassing op de geteste route en het profiel.
Leesregel: Stel eerst de juiste taakvoltooiing vast. Vergelijk daarna de responstiming. Kies de stem en de kostenband binnen een geschikte shortlist.
2. Onderzoeksopzet en dekking
Laag | Dekking | Betekenis |
|---|---|---|
LLM | 33 / 528 | 16 beslissingsverzoeken per model |
STT | 23 / 304 | 16 menselijke fragmenten; taalkeuze per route |
TTS | 29 / 228 | 4 zinnen per geschikte taal |
Native audiomodellen | 9 | Modellen over meerdere modi |
WebRTC | 44 / 22 | Taalcellen / configuraties, DE+EN |
Testroute | WebRTC / EU | Geen gecontroleerde PSTN-vergelijking |
LiveKit SDK | 1.8.6 | Eén SDK-versie in de gecontroleerde run |
De ingeschakelde catalogus is een momentopname van de inventaris. Het bewijst niet dat elke taal, elk plan of elke integratieroute gekwalificeerd was. Component- en gesprekstests beantwoorden verschillende vragen. Een LLM kan correcte JSON produceren terwijl de complete agent een ongeschikte gesproken bevestiging geeft. Snelle TTS kan nog steeds achter trage beurtdetectie of tool-continuïteit aanlopen.
De 44 WebRTC-cellen vertegenwoordigen 22 configuraties in twee talen, met één gesprek per taal en configuratie. Elke servicesuite bevat vier gecontroleerde positieve taken. Voltooide suites bevatten ook een begrensde onderbrekings- en herstelcontrole. De 47 terminalgesprekken in de bewijzenset bevatten drie pilots. Ze vormen geen herhaalde proeven van de 44 vergelijkingscellen.
Runs waren sequentieel, zonder gerandomiseerde volgorde of herhalingsreeksen. Opwarmeffecten, netwerkomstandigheden en providerwijzigingen in de loop van de tijd kunnen de observaties beïnvloeden. Behandel dit als een gedocumenteerde screeningsfase voor je volgende kwalificatieronde.
3. Begrijp de engine-architecturen
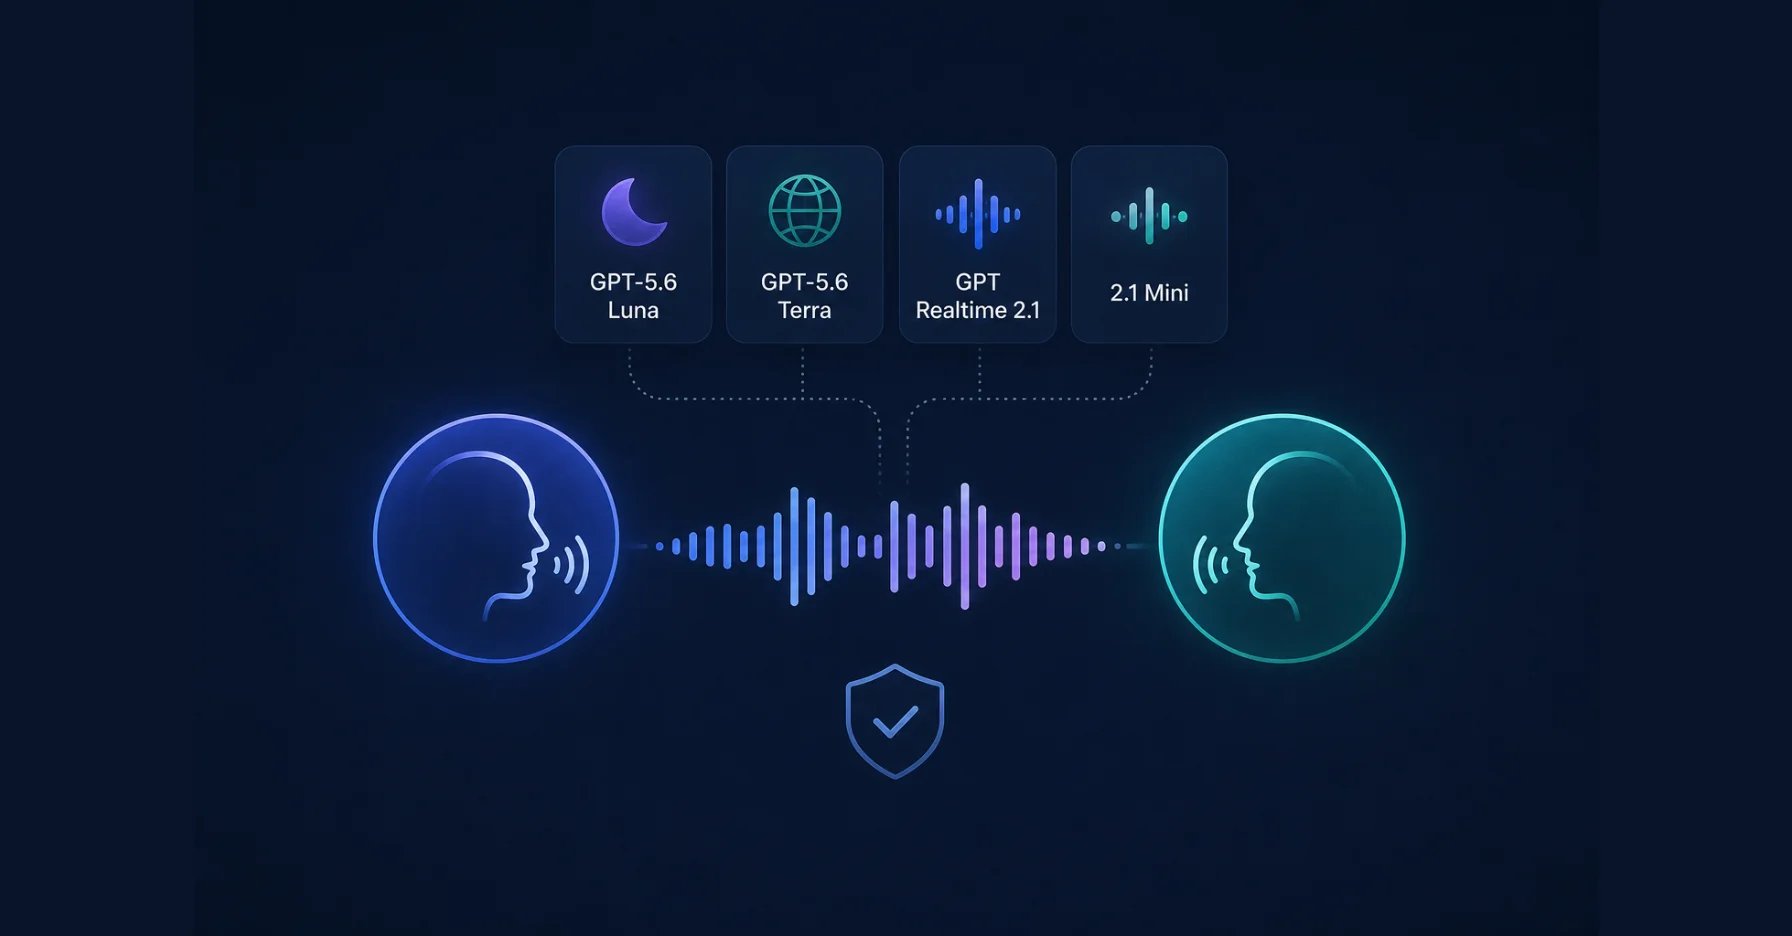
Conceptillustratie. Glasmodules vertegenwoordigen herkenning, redenering en spraakgeneratie, zonder gemeten waarden.
Modus | Pad | Kwalificatiefocus |
|---|---|---|
Pipeline | STT → LLM → TTS | Herkenning, tool-feiten, stem |
Half-Cascade | Native audio → externe TTS | Tool-continuïteit en stem |
Realtime | Native audio → native audio | Gesproken feiten en actie |
Full Duplex | Overlappende spraak | Luisteren, onderbrekingen, uitkomst |
Vertalen | DE→EN / EN→DE | Inhoud en kritieke entiteiten |
Een pipeline scheidt herkenning, redenering en spraakgeneratie. Elke component kan onafhankelijk worden geëvalueerd en gewijzigd. Half-Cascade combineert native audiobegrip met een externe stem. Realtime produceert spraak in het native audiomodel. Full Duplex voegt gedrag bij overlappende spraak toe. Vertalen heeft een ander doel en krijgt een afzonderlijke evaluatie.
Gelijkwaardige statistieken moeten gelijkwaardige gebeurtenissen beschrijven. Het eerste teksttoken van een pipeline is niet het eerste audiotoken van een native model. Ontbrekende componenttimings blijven daarom ontbreken. Voor complete gesprekken gebruikt dit rapport de bevestigingsproxy aan de kant van de beller naast expliciete taakcontroles.
4. De vergelijking van de complete pipeline
Provider | TTS-model | Controles | n | P50 ms | P95 ms |
|---|---|---|---|---|---|
 Gradium | default | 8/8 | 8 | 1167 | 1272 |
 Deepgram | aura-2 | 8/8 | 8 | 1201 | 1425 |
 Cartesia | sonic-3.6-2026-08-27 | 8/8 | 8 | 1241 | 1371 |
 ElevenLabs | eleven_v4_turbo | 8/8 | 8 | 1250 | 1326 |
 Rime | coda | 8/8 | 8 | 1261 | 1499 |
 Inworld | inworld-tts-2 | 8/8 | 8 | 1269 | 1392 |
 Soniox | tts-rt-v2 | 8/8 | 8 | 1429 | 1616 |
 Fish Audio | s2.1-pro | 8/8 | 8 | 1530 | 1610 |
 xAI | tts-1 | 8/8 | 8 | 1580 | 3054 |
Gemma 4 31B IT en Soniox STT v5 blijven constant. De tabel noemt de geteste TTS-configuraties. De timing begint aan het einde van de spraak van de beller en eindigt bij het eerste ontvangen niet-stille audioframe nadat de bijbehorende HTTP-fixture-ontvangst arriveert. Het omvat netwerk, actie, continuïteit en audiolevering. Dat frame alleen verifieert niet de tijdstempel van het eerste betekenisvolle bevestigingswoord.
Elke pipeline slaagde voor 8/8 taakcontroles en 2/2 begrensde onderbrekings-/herstelcontroles. Dit is een positief resultaat voor deze vaste gevallen. Het is geen resolutiepercentage voor klantgesprekken. De tool gaf een gecontroleerde HTTP-echo-ontvangst, in plaats van een afspraak te noteren of een CRM-record te wijzigen.
De eerste zes P50-waarden liggen relatief dicht bij elkaar. Met acht beurten en geen herhaalde proeven, vormen kleine verschillen geen gescheiden winnaars. De xAI-configuratie heeft in deze run een merkbaar hogere P95-steekproef dan zijn P50. Dat vraagt om herhaalde proeven en een inspectie van de individuele gebeurtenissen.
5. Elke native gespreksconfiguratie
Configuratie | Controles | Suites | n | P50 ms | P95 ms |
|---|---|---|---|---|---|
 realtime-gpt-realtime-2.1 | 8/8 | 2/2 | 8 | 2658 | 2895 |
half_cascade-gpt-realtime-2.1 | 7/8 | 2/2 | 8 | 1889 | 2711 |
half_cascade-gpt-realtime-2 | 7/8 | 2/2 | 8 | 2320 | 4118 |
half_cascade-gpt-realtime-2.1-mini | 6/8 | 2/2 | 8 | 2260 | 10300 |
realtime-gpt-realtime-2.1-mini | 6/8 | 2/2 | 8 | 2406 | 12913 |
realtime-gpt-realtime-2 | 6/8 | 2/2 | 8 | 2917 | 4975 |
 realtime-gemini-2.5-flash-native-audio-preview-12-2025 | 1/2 | 0/2 | 2 | 4508 | 11117 |
realtime-gpt-live-1 | WAV 6/8 | 2/2 | 8 | 1550 | 5698 |
half_cascade-gpt-realtime-mini | 0/0 | 0/2 | 0 | N/A | N/A |
realtime-gemini-3.1-flash-live-preview | 0/0 | 0/2 | 0 | N/A | N/A |
realtime-gemini-3.8-live | 0/0 | 0/2 | 0 | N/A | N/A |
realtime-gemini-3.8-live-extended-thinking | 0/0 | 0/2 | 0 | N/A | N/A |
realtime-gpt-realtime-mini | 0/0 | 0/2 | 0 | N/A | N/A |
GPT Realtime 2.1 voltooide de acht gecontroleerde servicefeiten. Half-Cascade met GPT Realtime 2.1 en GPT Realtime 2 bereikten elk 7/8. Hun Mini-tegenhangers bereikten 6/8. Timings blijven zichtbaar wanneer een taak zijn kwaliteitscontrole niet haalt. Een snelle mislukte beurt wordt niet geteld als een succesvol resultaat.
Gemini- en oudere Realtime Mini-suites stopten na het missen van bijbehorende tool-aanroepen of hoorbare continuïteit. Latere taken werden niet geprobeerd. Een 0/0-invoer betekent daarom geen evalueerbare taakcontroles. Het betekent niet perfecte kwaliteit of vier bewezen mislukkingen per taal. Verder werk moet de route, de gebeurtenisvolgorde en het continuïteitsgedrag isoleren.
Voor Full Duplex met GPT Live 1 hadden beide taalcellen correcte tool-ontvangsten. Onafhankelijke herkenning van ontvangen WAV-bestanden bevestigde zes van de acht gesproken feiten: het Duitse beleidsantwoord miste het 14-dagenfeit en het Engelse miste de boekingsbevestiging. Directe modeltranscripties waren onvolledig. De WAV-controle wordt afzonderlijk getoond in plaats van behandeld als identiek aan transcriptie-gebaseerde controles. Deze servicesuite heeft nog kwalificatie van hoorbare resultaten nodig.
Vertalen werd afzonderlijk geëvalueerd in DE→EN en EN→DE. Beide leverden audio en behielden datum-, tijd- en Berlijnse entiteiten. Eén Duits zelfstandig naamwoord bleef ambigu in onafhankelijke herkenning. Twee richtingen stellen geen breed vertaalkwaliteitspercentage vast. Een negatieve streaming-inzet vertegenwoordigt overlap, geen negatieve reactieve responstijd.
6. LLM's: alle 33 modellen in het beslissingsprofiel
Model | Checks | Niet-leeg | n | P50 ms | P95 ms |
|---|---|---|---|---|---|
google/gemma-4-31b-it | 16/16 | 16 | 16 | 162 | 535 |
openai/gpt-4.1 | 16/16 | 16 | 16 | 339 | 440 |
openai/gpt-4o | 16/16 | 16 | 16 | 389 | 890 |
openai/gpt-5.4-mini | 16/16 | 16 | 16 | 411 | 513 |
 deepseek-ai/deepseek-v4.1-flash | 16/16 | 16 | 16 | 494 | 821 |
openai/gpt-5.1 | 16/16 | 16 | 16 | 527 | 633 |
openai/gpt-5.6-luna | 16/16 | 16 | 16 | 561 | 1664 |
openai/gpt-5.2 | 16/16 | 16 | 16 | 575 | 663 |
openai/gpt-5.4 | 16/16 | 16 | 16 | 591 | 689 |
openai/gpt-5.6-sol | 16/16 | 16 | 16 | 654 | 2635 |
google/gemini-3.5-flash-lite | 16/16 | 16 | 16 | 698 | 1213 |
google/gemini-3.1-flash-lite | 16/16 | 16 | 16 | 707 | 4930 |
google/gemini-3.6-flash | 16/16 | 16 | 16 | 743 | 1362 |
google/gemini-3-flash-preview | 16/16 | 16 | 16 | 928 | 1180 |
google/gemini-3.5-flash | 16/16 | 16 | 16 | 1017 | 3469 |
openai/gpt-6-luna | 16/16 | 16 | 16 | 1145 | 2434 |
openai/gpt-5.5 | 16/16 | 16 | 16 | 1235 | 2645 |
xai/grok-4.7 | 16/16 | 16 | 16 | 5860 | 14607 |
openai/gpt-4.1-mini | 15/16 | 16 | 16 | 316 | 393 |
openai/gpt-5.6-terra | 15/16 | 15 | 15 | 576 | 827 |
xai/grok-4.20-0309-reasoning | 15/16 | 15 | 15 | 7864 | 17818 |
openai/gpt-5.4-nano | 14/16 | 15 | 15 | 400 | 520 |
google/gemini-3.7-flash | 13/16 | 16 | 16 | 2440 | 7146 |
xai/grok-4.20-multi-agent-0309 | 12/16 | 14 | 14 | 9672 | 19539 |
google/gemini-3.8-flash | 11/16 | 16 | 16 | 2625 | 10380 |
openai/gpt-4.1-nano | 10/16 | 16 | 16 | 284 | 364 |
openai/gpt-4o-mini | 10/16 | 16 | 16 | 345 | 740 |
xai/grok-4.20-0309-non-reasoning | 7/16 | 16 | 16 | 1070 | 6367 |
openai/gpt-5 | 5/16 | 6 | 6 | 2885 | 5624 |
google/gemini-3.1-pro-preview | 3/16 | 16 | 16 | 3697 | 6223 |
openai/gpt-5-mini | 0/16 | 1 | 1 | 2941 | 2941 |
openai/chat-latest | 0/16 | 0 | 0 | N.v.t. | N.v.t. |
openai/gpt-5-nano | 0/16 | 0 | 0 | N.v.t. | N.v.t. |
Elk model ontving 16 korte gestructureerde beslissingen, met een oorspronkelijke outputlimiet van 256 tokens. De checks omvatten feiten uit de testomgeving, verwachte acties en het weigeren van niet-ondersteunde of ongeoorloofde acties. De tabel scheidt beslissingschecks, niet-lege outputs en timing-samples. P50 en P95 gebruiken alleen observaties met beschikbare timings.
16/16 is een grove toegangspoort bij deze steekproefomvang. Zelfs onder een vereenvoudigde onafhankelijke binominale aanname is de onderste 95%-Wilson-grens ongeveer 80,6%. Deze vaste gevallen zijn bovendien geen willekeurige steekproef van klantvragen. Het interval biedt daarom geen garantie voor productieomgevingen.
Aparte GPT-5-hercontroles met een limiet van 1.536 tokens verbeterden de niet-lege antwoorden. Deze gebruiken een ander budget en vervangen niet stilletjes de baseline van 256 tokens. Wanneer een redenerend model zijn limiet verbruikt voordat het output genereert, controleer dan de configuratie. Een lege output of een HTTP 400-routeringsfout betekent niet dat het model intrinsiek niet in staat is de vraag van de klant te beantwoorden.
Gemma 4 en andere 16/16-kandidaten zoals GPT-4.1, GPT-4o, GPT-5.4 Mini en DeepSeek V4.1 Flash zijn verstandige startpunten. Vervolg met langere contexten, echte tool-argumenten, correcties en gesprekken in meerdere stappen. Een kleine beslissingsscreening vervangt die tweede fase niet.
7. STT: menselijke spraak en aangeleverde referenties
De nauwkeurigheidsscreening gebruikt 16 menselijke opnames uit Google FLEURS. Duits en Engels worden afzonderlijk gescoord. Elke kandidaat binnen een taal ontvangt dezelfde bestanden en referentieteksten. De selectie bevat 82,56 seconden aan Duits en 54,14 seconden aan Engels, met respectievelijk 161 en 124 referentiewoorden.
Duits: volledige en afzonderlijk gekwalificeerde resultaten
Model | Profiel | Fragmenten | Woorden | Wijzigingen | WER | Kwalificatie |
|---|---|---|---|---|---|---|
elevenlabs/scribe_v2_realtime | credential_or_eof_recheck | 8/8 | 161 | 1 | 0.62% | volledig kort corpus |
google/gemini-3.5-transcribe-live | baseline | 8/8 | 161 | 2 | 1.24% | volledig kort corpus |
 assemblyai/u3-rt-pro | baseline | 8/8 | 161 | 3 | 1.86% | volledig kort corpus |
assemblyai/universal-3-5-pro | baseline | 8/8 | 161 | 3 | 1.86% | volledig kort corpus |
assemblyai/universal-3-6-pro | baseline | 8/8 | 161 | 3 | 1.86% | volledig kort corpus |
 speechmatics/linden-1 | baseline | 8/8 | 161 | 4 | 2.48% | volledig kort corpus |
stt-rt-v5 | credential_or_eof_recheck | 8/8 | 161 | 6 | 3.73% | volledig kort corpus |
xai/stt-1 | baseline | 8/8 | 161 | 6 | 3.73% | volledig kort corpus |
xai/stt-2 | baseline | 8/8 | 161 | 6 | 3.73% | volledig kort corpus |
deepgram/nova-3 | baseline | 8/8 | 161 | 7 | 4.35% | volledig kort corpus |
deepgram/flux-general-multi | baseline | 8/8 | 161 | 10 | 6.21% | volledig kort corpus |
deepgram/nova-2 | baseline | 8/8 | 161 | 12 | 7.45% | volledig kort corpus |
cartesia/ink-whisper | baseline | 8/8 | 161 | 13 | 8.07% | volledig kort corpus |
 solaria-1 | gladia_protocol_recheck | 5/8 | 112 | 7 | 6.25% | gedeeltelijk; niet gerangschikt |
assemblyai/universal-streaming-multilingual | baseline | 8/8 | 161 | 176 | 109.32% | dubbel eind-artefact; niet gerangschikt |
Engels: volledige en afzonderlijk gekwalificeerde resultaten
Model | Profiel | Clips | Woorden | Edits | WER | Kwalificatie |
|---|---|---|---|---|---|---|
assemblyai/u3-rt-pro | baseline | 8/8 | 124 | 3 | 2.42% | volledig kort corpus |
assemblyai/universal-3-5-pro | baseline | 8/8 | 124 | 3 | 2.42% | volledig kort corpus |
assemblyai/universal-3-6-pro | baseline | 8/8 | 124 | 3 | 2.42% | volledig kort corpus |
cartesia/ink-2 | baseline | 8/8 | 124 | 3 | 2.42% | volledig kort corpus |
elevenlabs/scribe_v2_realtime | credential_or_eof_recheck | 8/8 | 124 | 4 | 3.23% | volledig kort corpus |
deepgram/flux-general-en | baseline | 8/8 | 124 | 8 | 6.45% | volledig kort corpus |
google/gemini-3.5-transcribe-live | baseline | 8/8 | 124 | 9 | 7.26% | volledig kort corpus |
stt-rt-v5 | credential_or_eof_recheck | 8/8 | 124 | 10 | 8.06% | volledig kort corpus |
speechmatics/linden-1 | baseline | 8/8 | 124 | 10 | 8.06% | volledig kort corpus |
deepgram/flux-general-multi | baseline | 8/8 | 124 | 12 | 9.68% | volledig kort corpus |
deepgram/nova-3 | baseline | 8/8 | 124 | 14 | 11.29% | volledig kort corpus |
deepgram/nova-3-pharma | baseline | 8/8 | 124 | 16 | 12.90% | volledig kort corpus |
deepgram/nova-2-conversationalai | baseline | 8/8 | 124 | 17 | 13.71% | volledig kort corpus |
deepgram/nova-2-medical | baseline | 8/8 | 124 | 18 | 14.52% | volledig kort corpus |
deepgram/nova-2-phonecall | baseline | 8/8 | 124 | 18 | 14.52% | volledig kort corpus |
deepgram/nova-3-medical | baseline | 8/8 | 124 | 18 | 14.52% | volledig kort corpus |
deepgram/nova-2 | baseline | 8/8 | 124 | 20 | 16.13% | volledig kort corpus |
solaria-1 | gladia_protocol_recheck | 4/8 | 51 | 3 | 5.88% | gedeeltelijk; niet gerangschikt |
cartesia/ink-whisper | baseline | 6/8 | 99 | 29 | 29.29% | gedeeltelijk; niet gerangschikt |
xai/stt-1 | baseline | 6/8 | 99 | 33 | 33.33% | gedeeltelijk; niet gerangschikt |
xai/stt-2 | baseline | 6/8 | 99 | 33 | 33.33% | gedeeltelijk; niet gerangschikt |
assemblyai/universal-streaming | baseline | 8/8 | 124 | 84 | 67.74% | duplicaat-eindartefact; niet gerangschikt |
assemblyai/universal-streaming-multilingual | baseline | 7/8 | 114 | 120 | 105.26% | duplicaat-eindartefact; niet gerangschikt |
Micro WER is het totaal aan substituties, verwijderingen en toevoegingen gedeeld door het totaal aantal referentiewoorden. Het is niet het gemiddelde van acht clip-niveaus. Eén extra bewerking verandert de Duitse WER met ongeveer 0,62 procentpunt en de Engelse met ongeveer 0,81 punt. Het samenvoegen van DE en EN zou Duits meer gewicht geven door het grotere aantal woorden.
Gedeeltelijke corpora worden apart geïdentificeerd. Hun WER beschrijft alleen succesvol geëvalueerde clips en kan niet eerlijk worden vergeleken met volledige corpora. Ontbrekende transcripties zijn geen foutloze herkenning. Resultaten van AssemblyAI Universal Streaming met gedupliceerde eindhypotheses vallen eveneens buiten de vergelijkende rangschikking. WER kan boven de 100% uitkomen wanneer er veel extra woorden worden ingevoegd. De afhandeling van segmenten en formatters vereist kwalificatie voordat deze artefacten als herkenningskwaliteit worden geïnterpreteerd.
De selectie is afkomstig uit de validatieset en bevat voorgelezen spraak. Duitse opnames hebben mannelijke metadata; Engels bevat vier mannelijke en vier vrouwelijke vermeldingen. Dit is geen representatieve dekking van accenten, spontane spraak, ruis of telefonie. Het stelt ook geen afzonderlijke sprekeridentiteiten vast. Voeg je eigen namen, klantidentificaties, tijden, producttermen en telefoonaudio toe voor acceptatie.
8. TTS: alle 29 modellen en het eerste audiofragment
Model | Profiel | Audio | P50 ms | P95 ms |
|---|---|---|---|---|
eleven_v3_conversational | baseline | 8/8 | 125 | 702 |
elevenlabs/eleven_v4_turbo | baseline | 8/8 | 129 | 141 |
elevenlabs/eleven_flash_v2_5 | baseline | 8/8 | 138 | 1265 |
elevenlabs/eleven_turbo_v2_5 | baseline | 8/8 | 179 | 225 |
cartesia/sonic-latest | baseline | 8/8 | 182 | 231 |
cartesia/sonic-3.6-2026-08-27 | baseline | 8/8 | 186 | 222 |
cartesia/sonic-preview | baseline | 8/8 | 187 | 231 |
gradium/default | baseline | 8/8 | 192 | 264 |
cartesia/sonic-3.6 | baseline | 8/8 | 197 | 205 |
cartesia/sonic-3-latest | baseline | 8/8 | 217 | 1274 |
cartesia/sonic-3.5 | baseline | 8/8 | 219 | 250 |
cartesia/sonic-3.5-2026-05-04 | baseline | 8/8 | 236 | 243 |
cartesia/sonic-3 | baseline | 8/8 | 238 | 325 |
cartesia/sonic-3-2026-01-12 | baseline | 8/8 | 260 | 293 |
inworld/inworld-tts-2-flash | baseline | 8/8 | 338 | 676 |
inworld/inworld-tts-1.5-mini | baseline | 8/8 | 357 | 578 |
inworld/inworld-tts-2 | baseline | 8/8 | 359 | 654 |
inworld/inworld-tts-1.5-max | baseline | 8/8 | 415 | 454 |
deepgram/aura-2 | baseline | 8/8 | 476 | 762 |
elevenlabs/eleven_v3 | baseline | 8/8 | 487 | 766 |
deepgram/flux-tts | flux_model_voice_recheck | 4/4 | 538 | 740 |
rime/coda | baseline | 8/8 | 601 | 637 |
elevenlabs/eleven_v4 | baseline | 8/8 | 638 | 775 |
soniox/tts-rt-v2 | credential_or_eof_recheck | 8/8 | 718 | 771 |
elevenlabs/eleven_multilingual_v2 | baseline | 8/8 | 868 | 1920 |
xai/tts-1 | baseline | 8/8 | 876 | 949 |
fishaudio/s2.1-pro | baseline | 8/8 | 1191 | 1758 |
fishaudio/s2-pro | baseline | 8/8 | 1237 | 1317 |
gpt-4o-mini-tts | baseline | 3/8 | 1154 | 1550 |
Elke taal gebruikt vier vaste korte zinnen en één vaste stem. Lokale TTFB loopt van het begin van de aanvraag bij de fabriek/provider tot het eerste PCM-fragment. Het eindigt vóór de hoorbare reactie van de beller. Dit is een componentmeting in plaats van een volledige gesprekstijd.
Eleven v3 Conversational, Eleven v4 Turbo, Flash, recente Cartesia-configuraties en Gradium waren snelle kandidaten in dit profiel. Hun volgorde kan veranderen in een volledige pipeline. Deepgram Aura-2 vertoonde bijvoorbeeld een hogere lokale componenttijd dan verschillende modellen, terwijl de volledige Deepgram-pipeline een van de lagere tijden voor bevestiging aan de beller had. Grenzen, gegenereerde tekst en streamingpaden verschillen.
Flux TTS werd opnieuw gecontroleerd met zijn compatibele Alexis-stem op vier Engelse zinnen. Die EN-only hertest staat expliciet los van de tweetalige baseline-rijen. GPT-4o Mini TTS gaf drie van de acht baseline-samples terug; de tijden hebben betrekking op die drie beschikbare outputs in plaats van acht succesvolle antwoorden.
Geen geblindeerde jury heeft natuurlijkheid, uitspraak of stemvoorkeur beoordeeld. Luister naar je shortlist met je eigen vocabulaire: persoons- en bedrijfsnamen, e-mailadressen, decimalen, tijden, afkortingen en taalwisselingen. Beoordeel de verstaanbaarheid vóór de merkfit. Een snel eerste fragment meet geen van beide.
9. Kostenklassen: Laag, Gemiddeld en Hoog
Pipeline | Kostenklasse | Onderbouwing |
|---|---|---|
Gradium | Hoog | Bekend LLM/TTS-aandeel; volledige kosten onopgelost |
Deepgram | Gemiddeld | Bekend LLM/TTS-aandeel; volledige kosten onopgelost |
Cartesia | Hoog | Bekend LLM/TTS-aandeel; volledige kosten onopgelost |
ElevenLabs | Onopgelost | Ontbrekend TTS-tarief of facturatiehoeveelheden |
Rime | Gemiddeld | Bekend LLM/TTS-aandeel; volledige kosten onopgelost |
Inworld | Laag | Bekend LLM/TTS-aandeel; volledige kosten onopgelost |
Soniox | Onopgelost | Ontbrekend TTS-tarief of facturatiehoeveelheden |
Fish Audio | Laag | Bekend LLM/TTS-aandeel; volledige kosten onopgelost |
xAI | Laag | Bekend LLM/TTS-aandeel; volledige kosten onopgelost |
Deze klassen beschrijven alleen het relatieve bekende LLM/TTS-inferentieaandeel voor zeven vergelijkbare pipeline-paren. Elk paar gebruikt de twee voltooide DE/EN-gesprekken, sluit pilots uit en heeft toewijsbare LLM- en TTS-hoeveelheden met gerefereerde openbare tarieven. Rangschik de zeven bekende subtotalen: de eerste drie krijgen Laag, de volgende twee Gemiddeld en de laatste twee Hoog. De klassen zijn relatief aan dit experiment, niet aan de Famulor-abonnementsniveaus.
STT-tokenhoeveelheden, enig gebruik van detectoren, transport, infrastructuur, opname, kortingen en factuurkosten ontbreken of zijn onvolledig toegewezen. Het exacte tarief voor Eleven v4 Turbo is niet beschikbaar; Soniox mist overeenkomstige facturatiehoeveelheden. Beide blijven Onopgelost. Native-modi zijn niet in deze pipeline-klassen opgenomen. Reactielengtes, begroetingen en onderbrekingsreacties beïnvloeden ook de bekende aandelen.
Laag betekent niet de goedkoopste complete stack. Hoog betekent niet een hoog Famulor-tarief. De bandbreedtes helpen bij het interpreteren van een vergelijkbaar opgenomen deel van het testgebruik. De werkelijke kosten per opgeloste klantoproep vereisen een volledige kostentoerekening en geverifieerde bedrijfsresultaten. Dit rapport publiceert geen interne monetaire bedragen.
10. Vier workflows en hun acceptatievragen
Workflow | Key check | Volgende kwalificatie |
|---|---|---|
Service | Beleid en identificatie | Onzekerheid en bevestigde overdracht |
Boeking | Slot, tijdzone, één actie | Verifieer de opgeslagen kalenderstatus |
Verkoop | Feiten en kwalificatie | Onbekende aanbiedingen en ontbrekende details |
Support | Stappen en wachtwoordbeveiliging | Correctie, toolfout, onderbreking |
De workflowtabellen tonen de observaties voor de twee talen als een bereik. Elke combinatie heeft één positieve taak per taal. De lagere observatie is geen betrouwbaar sectorgemiddelde. Alleen gecontroleerde, geslaagde taakparen worden weergegeven. Deze verschillen kunnen geen specialistische kwaliteitswinnaar voor klantenservice of verkoop aanwijzen.
Klantenservice
Configuratie | Gecontroleerde beurten | Lager ms | Hoger ms |
|---|---|---|---|
pipeline-gradium | 2 | 779 | 1095 |
pipeline-rime | 2 | 874 | 1261 |
pipeline-inworld | 2 | 881 | 1185 |
pipeline-soniox | 2 | 1001 | 1350 |
pipeline-cartesia | 2 | 1049 | 1204 |
pipeline-deepgram | 2 | 1178 | 1308 |
pipeline-elevenlabs | 2 | 1250 | 1261 |
pipeline-fishaudio | 2 | 1284 | 1530 |
pipeline-xai | 2 | 1445 | 3054 |
half_cascade-gpt-realtime-2.1-mini | 2 | 1471 | 1551 |
half_cascade-gpt-realtime-2.1 | 2 | 1780 | 1994 |
half_cascade-gpt-realtime-2 | 2 | 1990 | 2320 |
realtime-gpt-realtime-2.1-mini | 2 | 2157 | 2260 |
realtime-gpt-realtime-2 | 2 | 2400 | 2496 |
realtime-gpt-realtime-2.1 | 2 | 2677 | 2710 |
Controleer goedgekeurd beleid, identificaties, correcties en verzoeken voor een persoon. De gecontroleerde taak toetste een bekend beleidsfeit en de ontvangstbevestiging daarvan. Een echte acceptatiesuite heeft ook behoefte aan onvolledige informatie, tegenstrijdige verzoeken en bevestigde overdrachten.
Afspraak boeken
Configuratie | Gecontroleerde beurten | Lager ms | Hoger ms |
|---|---|---|---|
pipeline-gradium | 2 | 1128 | 1272 |
pipeline-elevenlabs | 2 | 1168 | 1326 |
pipeline-deepgram | 2 | 1186 | 1360 |
pipeline-cartesia | 2 | 1241 | 1352 |
pipeline-rime | 2 | 1244 | 1480 |
pipeline-inworld | 2 | 1269 | 1392 |
pipeline-soniox | 2 | 1400 | 1616 |
pipeline-fishaudio | 2 | 1481 | 1610 |
pipeline-xai | 2 | 1555 | 1582 |
realtime-gpt-realtime-2.1 | 2 | 2658 | 2688 |
Het doel is het correct aangeboden tijdslot, inclusief datum, tijd en tijdzone. Inspecteer de werkelijke status van de testkalender na het boeken. Vereis precies één opgeslagen actie en een bijbehorende gesproken bevestiging. Voeg onbeschikbare slots, verduidelijkingen, het verzetten van afspraken en herhaalde tool-levering toe om dubbele boekingen te detecteren.
Verkoop
Configuratie | Gecontroleerde beurten | Lager ms | Hoger ms |
|---|---|---|---|
pipeline-gradium | 2 | 1167 | 1250 |
pipeline-deepgram | 2 | 1174 | 1425 |
pipeline-rime | 2 | 1232 | 1469 |
pipeline-cartesia | 2 | 1239 | 1292 |
pipeline-elevenlabs | 2 | 1247 | 1257 |
pipeline-inworld | 2 | 1249 | 1359 |
pipeline-soniox | 2 | 1429 | 1509 |
pipeline-fishaudio | 2 | 1521 | 1540 |
pipeline-xai | 2 | 1664 | 1731 |
half_cascade-gpt-realtime-2.1 | 2 | 1827 | 1990 |
half_cascade-gpt-realtime-2 | 2 | 1878 | 2485 |
realtime-gpt-realtime-2.1-mini | 2 | 2128 | 3026 |
realtime-gpt-realtime-2.1 | 2 | 2537 | 2616 |
realtime-gpt-realtime-2 | 2 | 4728 | 4975 |
De controles dekten vaste productfeiten en de verwachte actie. De volgende fase vereist onzekere verzoeken, ontbrekende details en niet-goedgekeurde aanbiedingen. Prijs- en stoelfeiten in de fixtures waren fictieve testgegevens. Het zijn geen Famulor-prijzen en ze worden niet gereproduceerd als commerciële aanbiedingen.
Technische ondersteuning
Configuratie | Gecontroleerde beurten | Lager ms | Hoger ms |
|---|---|---|---|
pipeline-deepgram | 2 | 1201 | 1268 |
pipeline-gradium | 2 | 1205 | 1209 |
pipeline-elevenlabs | 2 | 1237 | 1318 |
pipeline-inworld | 2 | 1269 | 1318 |
pipeline-cartesia | 2 | 1319 | 1371 |
pipeline-rime | 2 | 1430 | 1499 |
pipeline-soniox | 2 | 1478 | 1487 |
pipeline-fishaudio | 2 | 1539 | 1590 |
pipeline-xai | 2 | 1562 | 1580 |
half_cascade-gpt-realtime-2.1 | 2 | 1889 | 2206 |
half_cascade-gpt-realtime-2.1-mini | 2 | 1899 | 2541 |
half_cascade-gpt-realtime-2 | 2 | 2346 | 2444 |
realtime-gpt-realtime-2.1 | 2 | 2354 | 2895 |
realtime-gpt-realtime-2.1-mini | 2 | 2406 | 12913 |
realtime-gpt-realtime-2 | 2 | 2476 | 2954 |
De gecontroleerde casus gebruikte een bekende foutcode, een vaste reeks stappen en wachtwoordbeveiliging. Voeg mislukte stappen, nieuwe informatie en een onderbreking halverwege de instructies toe. Correct herstel adresseert het gewijzigde verzoek in plaats van de vorige alinea voort te zetten.
11. Leestiming aan de rechtergrens
Metriek | Start → einde | Betekenis |
|---|---|---|
Bevestigingsproxy | Beller einde → audio na ontvangst | Audio-inzet, geen woord-tijdstempel |
LLM TTFT | Verzoek → eerste teksttoken | Starttijd component |
TTS TTFB | Fabriek → eerste PCM-chunk | Component, niet beller-audio |
EOT | Gedetecteerd einde → beslissing beurt | SDK-waarde; onafhankelijke grenscontrole vereist |
Micro WER | (S + D + I) / N | Woordbewerkingen per referentiewoord |
P50 / P95 | Dichtstbijzijnde rangorde | Toon altijd n en profiel |
Tabellen gebruiken percentielen op basis van de dichtstbijzijnde rangorde: sorteer observaties en selecteer positie ceil(p × n). Bij n=8 is P95 de grootste van acht observaties. Het beschrijft de traagste gemeten beurt in die steekproef. Een stabiele productie-P95 vereist een aanzienlijk grotere, adequaat gestratificeerde dataset.
Beurten binnen een gesprek delen configuratie en netwerkomstandigheden. Acht beurten zijn geen acht onafhankelijke klantoproepen. Betrouwbaarheidsintervallen en herhalingen moeten het gesprek als een gedeelde eenheid respecteren. Het samenvoegen van beurten kan anders meer zekerheid suggereren dan het experiment ondersteunt.
Geëxporteerde pipeline-werkermetrieken
Pipeline | LLM n/P50/P95 | TTS n/P50/P95 | EOT n/P50/P95 |
|---|---|---|---|
pipeline-cartesia | 12 / 149 / 175 | 13 / 67 / 120 | 12 / 578 / 582 |
pipeline-deepgram | 12 / 148 / 159 | 13 / 137 / 884 | 12 / 578 / 579 |
pipeline-elevenlabs | 12 / 148 / 179 | 14 / 84 / 93 | 12 / 578 / 580 |
pipeline-fishaudio | 12 / 144 / 155 | 12 / 466 / 1344 | 12 / 578 / 579 |
pipeline-gradium | 12 / 145 / 159 | 14 / 90 / 149 | 12 / 578 / 580 |
pipeline-inworld | 13 / 146 / 204 | 13 / 186 / 309 | 12 / 578 / 580 |
pipeline-rime | 12 / 146 / 182 | 14 / 235 / 549 | 12 / 578 / 579 |
pipeline-soniox | 13 / 148 / 163 | 15 / 309 / 404 | 12 / 578 / 580 |
pipeline-xai | 12 / 145 / 157 | 12 / 418 / 745 | 12 / 578 / 2501 |
Afhankelijk van de export bevatten deze SDK-metrieken begroetingen, tool-continuaties en onderbrekingsreacties. Hun steekproefaantallen verschillen van de acht gecontroleerde taken. P50-waarden van componenten kunnen niet worden opgeteld om de P50 van het gesprek af te leiden: tijdlijnen overlappen en observatiesets verschillen.
12. Wat volledige rapportage nodig heeft
Metriek | Bewijs hier | Aanvullend bewijs nodig |
|---|---|---|
Tool/feitencheck | Fictieve ontvangstbewijzen + gesproken feiten | Echte actiestatus |
Resolutiegraad | Niet gemeten | Gelabelde echte uitkomsten en noemer |
Hallucinatiegraad | Vaste feit/weigering-checks | Onafhankelijke annotatie van materiële claims |
Overdracht | Geen nieuwe acceptatietest voor telefoon | Goedgekeurde bestemming en geverifieerde opname |
Uitvalpercentage | Begrensde observatie van verbreking | Volledige observaties van beide peers |
Natuurlijkheid | Geen blinde luisterjury | Luistertests met identieke scripts |
Kosten per resolutie | Niet gemeten | Volledige kosten en echte resolutie |
Een technisch voltooid gesprek is geen geverifieerde opgeloste klantcasus. Een geaccepteerd overdrachtcommando bewijst niet dat een mens de telefoon opneemt. Een overeenstemmende gesproken verklaring bewijst niet dat een actie is opgeslagen. Rapportage moet deze statussen afzonderlijk vastleggen en koppelen aan de verwachte taak.
Behoud voor elke casus de taal, configuratie, prompt/tool-versie, modelroute, tijd, verwachte actie, ontvangen ontvangstbewijs en gesproken resultaat. Houd Geslaagd, Mislukt, Niet geprobeerd en Niet opgelost gescheiden. Geef elke metriek zijn eigen juiste noemer. Een goede timing-observatie blijft dan nuttig zonder een mislukte uitkomst te verbergen.
Historische productie-aggregaten van de voorgaande week waren aanvullend operationeel bewijs. Ze zijn uitgesloten van de gecontroleerde volgorde omdat klanten, taken, instellingen en releases verschilden. Dat voorkomt dat observationele bedrijfsgegevens veranderen in een causale modelvergelijking.
13. Gebruik de Famulor API voor reproduceerbare checks
Doel | API-contract | Gebruik |
|---|---|---|
Catalogus | GET /user/assistants/models | Beschikbare model-ID's vastleggen |
Stemmen | GET /user/assistants/voices | Stem en taal vastzetten |
Aanbieders | GET /user/assistants/transcriber-providers | STT-route vastleggen |
Assistent testen | POST /user/assistant | Geïsoleerde testconfiguratie |
Gesprek | GET /user/calls/{id} | Gespreksgegevens en resultaat koppelen |
Na het gesprek | Webhook | Transcript, variabelen en opname |
Het bijgevoegde OpenAPI-bestand beschrijft het product-API-contract. Het levert geen benchmarkresultaten of een kant-en-klare kwaliteitsscore. Gebruik catalogus-endpoints om beschikbare modellen en stemmen vast te leggen op het moment van testen. Configureer een afzonderlijke testassistent en een tool met gecontroleerde antwoorden. Voer alleen een echte testoproep uit naar een goedgekeurde bestemming.
Het ophalen van gesprekken en post-call webhooks koppelen de gedocumenteerde gespreksinformatie, transcripten, geëxtraheerde variabelen en opnameverwijzingen. Metingen van spraakbeëindiging, audio-onset, tool-ontvangst en onderbrekingen in milliseconden vereisen aanvullende instrumentatie van het spraakpad. Gespreksduur en status zijn onvoldoende. Claim geen TTFT-, TTFB- of WER-velden tenzij je werkelijke response-contract deze levert.
Authenticatie maakt gebruik van een server-side Bearer-token. Houd inloggegevens, klantnummers, privéopnames en interne bedragen uit openbare rapporten. Geaggregeerde tabellen, duidelijke cases en geanonimiseerd bewijsmateriaal zijn geschikt om te delen.
14. Maak van de shortlist een acceptatieplan
Specificeer voor elke workflow de beoogde actie, de hoorbare bevestiging en de toegestane reactie op onzekerheid.
Kies verschillende volledig gecontroleerde kandidaten. Houd prompt, kennis, tool-antwoorden, regio en audio van de beller constant.
Herhaal cases in willekeurige volgorde. Scheid koude en warme starts. Bewaar alle mislukte pogingen.
Voeg spontane spraak, gevarieerde stemmen, telefooncodecs, ruis, pauzes, correcties en pakketverlies toe.
Controleer de werkelijke status van het testsysteem, zoals een agendaboeking. Beoordeel onafhankelijk zowel de ontvangen audio als de transcripten van het model.
Stel vóór de proef kwaliteits- en timingdrempels in. Beslis op basis van die drempels en onzekerheid in plaats van een achteraf gewogen winnaarsscore.
Voer de acceptatie opnieuw uit na wijzigingen in prompt, tools, route of engine. Bewaar regressieresultaten bij de bijbehorende versies.
Famulor-simulaties bieden een startpunt voor herhaalbare workflowcontroles. Voeg gesproken end-to-end-proeven toe wanneer klanten audio horen en antwoorden kunnen onderbreken. Geschreven simulatiescenario's zijn sjablonen; hun aanwezigheid bewijst niet dat er een aanvullende evaluatie is uitgevoerd.
15. Kies je eerste configuratie
Voor korte servicetaken die gebaseerd zijn op vaste tool-feiten, is een pipeline het sterkste startpunt in deze screening. Begin met Gemma 4 en een taalgeschikte STT. Vergelijk verschillende succesvolle stemmen, met name Gradium, Deepgram, Cartesia en ElevenLabs, met gebruik van je kritieke namen en cijfers. Behandel kostenbanden als aanvullende, gedeeltelijke observaties.
Kwalificeer Half-Cascade voor native audiobegrip in combinatie met een specifieke externe stem. Voor native gesproken antwoorden is GPT Realtime 2.1 een kandidaat uit deze kleine, voltooide suite. Focus voor Full Duplex op overlappende spraak en volledige hoorbare resultaten. Je workflow en acceptatiecriteria bepalen de keuze.
16. Bronnen en reproduceerbaarheid
De primaire meetbron is de versiebeheerde onderzoeks-snapshot van Famulor van 13 oktober 2026. Tabellen gebruiken de definitieve gecorrigeerde resultaten; eerdere beoordelingsnotities overschrijven latere resultaten niet. Geldbedragen, privé-gespreks-ID's en inloggegevens zijn uitgesloten van deze openbare editie.
Google FLEURS: Datasetkaart. Menselijke opnames en bijgeleverde transcripten, CC BY 4.0.
Conneau et al.: FLEURS, 2022. Corpusbeschrijving.
Creative Commons BY 4.0. Licentie en naamsvermelding.
NIST: ASR-statistieken. Interpretatie van de Word Error Rate.
LiveKit: Agent-statistieken. SDK-statistieken en meetgrenzen.
Famulor API-documentatie. Product-API en events.
De FLEURS-selectie gebruikt de_de en en_us, validatie, revisie 70bb2e84b976b7e960aa89f1c648e09c59f894dd. Duitse rijen: 0, 1, 2, 3, 5, 6, 8, 201. Engelse rijen: 0, 2, 3, 4, 5, 6, 7, 8. Audio werd geconverteerd naar PCM16 mono op 16 kHz, waarbij die wijziging werd vastgelegd. De auteurs en sprekers van het corpus onderschrijven dit rapport niet. Genormaliseerde verwijzingen en individuele gebeurtenissen horen in een reproductiedossier.
Vergelijk Famulor engine-modi, luister in de stemmenbibliotheek en plan je testconfiguratie. Boek een demo.
Auteur bij Famulor