Resumir contenido con:



Famulor Research · Octubre de 2026 · Medido el 13 de octubre de 2026 · Editado el 14 de octubre de 2026
Un agente de voz necesita realizar la acción correcta y confirmarla con claridad. La generación rápida de voz solo cubre una parte de esa tarea. Este estudio de Famulor compara modelos individuales, configuraciones de conversación completas y el audio que recibe la persona que llama. Obtendrás las tablas de resultados completas, bandas de costes relativas y un plan de aceptación que puedes aplicar a tus propios flujos de trabajo.
Contenido del estudio
1. Las conclusiones que importan
Las nueve configuraciones de canalización probadas superaron ocho de las ocho comprobaciones ficticias de recepción y hechos hablados. Con el reconocimiento de Gemma 4 y Soniox constante, su P50 de inicio de confirmación observado osciló entre 1.167 y 1.580 ms. Gradium, Deepgram, Cartesia y ElevenLabs forman una lista corta inicial rápida. Las otras cinco canalizaciones también completaron las tareas comprobadas.
Gemma 4 31B IT superó las 16 comprobaciones de decisión estructurada, con una mediana de tiempo para el primer token de texto de 162 ms. Muchos otros LLM también superaron 16/16. El tiempo describe este perfil en particular. No establece una inteligencia universal ni una clasificación de calidad.
Los resultados del reconocimiento de voz difieren según el idioma. Scribe v2 Realtime, en una reevaluación etiquetada por separado, realizó una edición sobre 161 palabras de referencia en alemán. Tres configuraciones de AssemblyAI Pro y Cartesia Ink 2 realizaron tres ediciones cada una sobre 124 palabras en inglés. Unas pocas palabras pueden cambiar el orden en un corpus tan pequeño.
Para los modelos nativos en tiempo real, la continuación de la herramienta es una comprobación clave. GPT Realtime 2.1 superó las ocho tareas de servicio. Otras configuraciones mostraron confirmaciones habladas faltantes, suites inacabadas o comportamiento de protocolo no resuelto. Estos hallazgos se aplican a la ruta y al perfil probados.
Regla de lectura: Establece primero la finalización correcta de la tarea. Compara el tiempo de respuesta en segundo lugar. Elige la voz y la banda de coste dentro de una lista corta adecuada.
2. Diseño y cobertura del estudio
Capa | Cobertura | Significado |
|---|---|---|
LLM | 33 / 528 | 16 solicitudes de decisión por modelo |
STT | 23 / 304 | 16 clips humanos; elegibilidad de idioma por ruta |
TTS | 29 / 228 | 4 frases por idioma elegible |
Modelos de audio nativos | 9 | Modelos en múltiples modos |
WebRTC | 44 / 22 | Celdas de idioma / configuraciones, DE+EN |
Ruta de prueba | WebRTC / UE | Sin comparación controlada de PSTN |
SDK de LiveKit | 1.8.6 | Una versión de SDK en la ejecución controlada |
El catálogo habilitado es una instantánea del inventario. No demuestra que cada idioma, plan o ruta de integración estuviera cualificado. Las pruebas de componentes y de conversación responden a preguntas diferentes. Un LLM puede producir JSON correcto mientras que el agente completo ofrece una confirmación hablada inadecuada. Un TTS rápido puede quedar detrás de una detección de turno lenta o de una continuación de herramienta.
Las 44 celdas WebRTC representan 22 configuraciones en dos idiomas, con una llamada por idioma y configuración. Cada suite de servicio contiene cuatro tareas positivas controladas. Las suites completadas también incluyen una comprobación de interrupción y recuperación limitada. Las 47 llamadas terminales en el conjunto de pruebas incluyen tres pilotos. No crean ensayos repetidos de las 44 celdas de comparación.
Las ejecuciones fueron secuenciales, sin orden aleatorio ni series repetidas. Los efectos de calentamiento, las condiciones de red y los cambios de proveedor a lo largo del tiempo pueden influir en las observaciones. Trata esto como una etapa de selección documentada para tu próxima ronda de cualificación.
3. Entender las arquitecturas de los motores
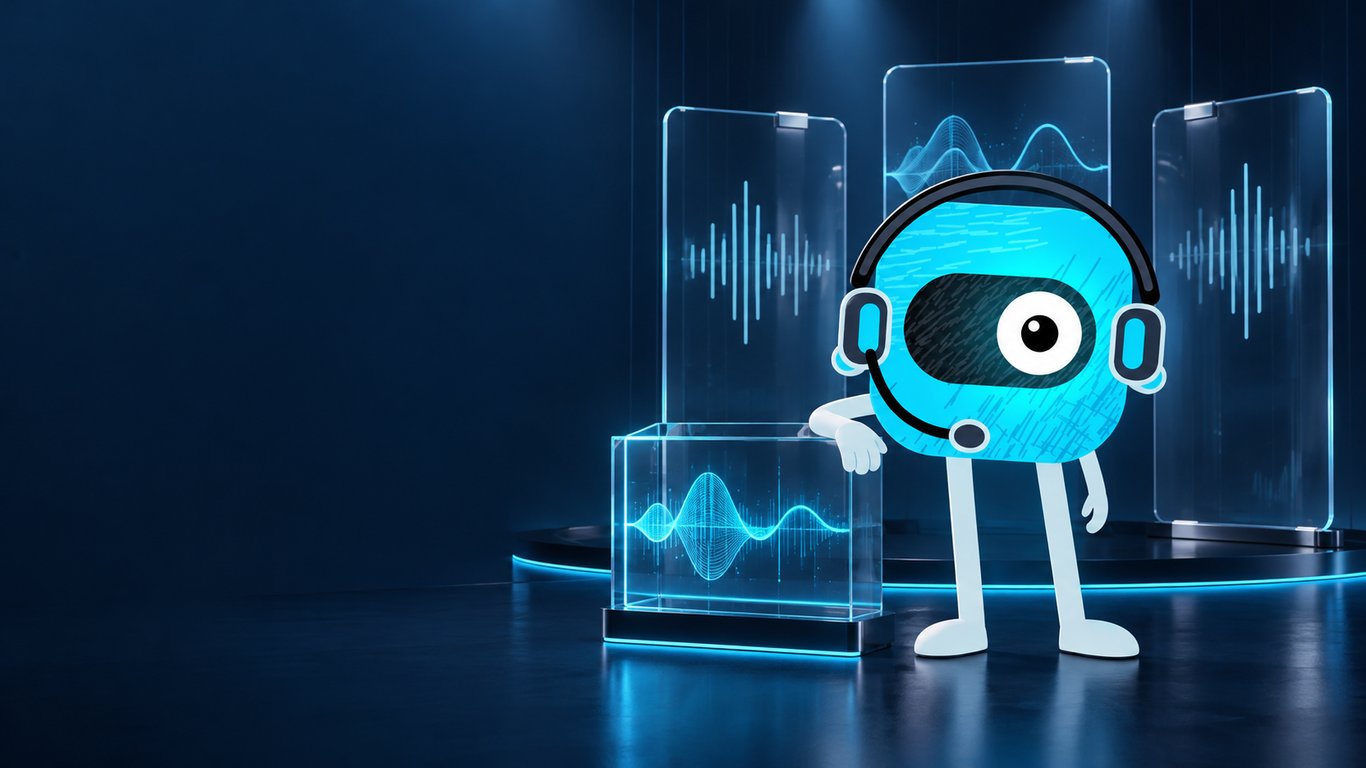
Ilustración conceptual. Los módulos de cristal representan el reconocimiento, el razonamiento y la generación de voz, sin valores medidos.
Modo | Ruta | Enfoque de cualificación |
|---|---|---|
Canalización | STT → LLM → TTS | Reconocimiento, hechos de herramientas, voz |
Media cascada (Half-Cascade) | Audio nativo → TTS externo | Continuación de herramienta y voz |
Tiempo real (Realtime) | Audio nativo → audio nativo | Hechos hablados y acción |
Dúplex completo (Full Duplex) | Voz superpuesta | Escucha, interrupciones, resultado |
Traducción | DE→EN / EN→DE | Contenido y entidades críticas |
Una canalización separa el reconocimiento, el razonamiento y la generación de voz. Cada componente puede evaluarse y cambiarse de forma independiente. La media cascada combina la comprensión de audio nativo con una voz externa. El tiempo real produce voz en el modelo de audio nativo. El dúplex completo añade un comportamiento de voz superpuesta. La traducción tiene un propósito diferente y recibe una evaluación separada.
Las métricas equivalentes deben describir eventos equivalentes. El primer token de texto de una canalización no es el primer token de audio de un modelo nativo. Por lo tanto, los tiempos de los componentes faltantes siguen sin estar disponibles. Para las llamadas completas, este informe utiliza el proxy de confirmación del lado de quien llama junto con comprobaciones de tareas explícitas.
4. La comparación completa de la canalización
Proveedor | Modelo TTS | Comprobaciones | n | P50 ms | P95 ms |
|---|---|---|---|---|---|
 Gradium | predeterminado | 8/8 | 8 | 1167 | 1272 |
 Deepgram | aura-2 | 8/8 | 8 | 1201 | 1425 |
 Cartesia | sonic-3.6-2026-08-27 | 8/8 | 8 | 1241 | 1371 |
 ElevenLabs | eleven_v4_turbo | 8/8 | 8 | 1250 | 1326 |
 Rime | coda | 8/8 | 8 | 1261 | 1499 |
 Inworld | inworld-tts-2 | 8/8 | 8 | 1269 | 1392 |
 Soniox | tts-rt-v2 | 8/8 | 8 | 1429 | 1616 |
 Fish Audio | s2.1-pro | 8/8 | 8 | 1530 | 1610 |
 xAI | tts-1 | 8/8 | 8 | 1580 | 3054 |
Gemma 4 31B IT y Soniox STT v5 permanecen constantes. La tabla nombra las configuraciones TTS probadas. El tiempo comienza al final del discurso de quien llama y termina en el primer fotograma de audio no silencioso recibido después de que llega la recepción del accesorio HTTP coincidente. Incluye red, acción, continuación y entrega de audio. Ese fotograma por sí solo no verifica la marca de tiempo de la primera palabra de confirmación significativa.
Cada canalización superó 8/8 comprobaciones de tareas y 2/2 comprobaciones de interrupción/recuperación limitada. Este es un resultado positivo para estos casos fijos. No es una tasa de resolución de llamadas de clientes. La herramienta devolvió un recibo de eco HTTP controlado, en lugar de escribir una cita o cambiar un registro CRM.
Los primeros seis valores de P50 están relativamente cerca. Con ocho turnos y sin ensayos repetidos, las pequeñas brechas no establecen ganadores separados. La configuración de xAI tiene un P95 de muestra notablemente más alto que su P50 en esta ejecución. Eso requiere ensayos repetidos y una inspección de los eventos individuales.
5. Cada configuración de conversación nativa
Configuración | Comprobaciones | Suites | n | P50 ms | P95 ms |
|---|---|---|---|---|---|
 realtime-gpt-realtime-2.1 | 8/8 | 2/2 | 8 | 2658 | 2895 |
half_cascade-gpt-realtime-2.1 | 7/8 | 2/2 | 8 | 1889 | 2711 |
half_cascade-gpt-realtime-2 | 7/8 | 2/2 | 8 | 2320 | 4118 |
half_cascade-gpt-realtime-2.1-mini | 6/8 | 2/2 | 8 | 2260 | 10300 |
realtime-gpt-realtime-2.1-mini | 6/8 | 2/2 | 8 | 2406 | 12913 |
realtime-gpt-realtime-2 | 6/8 | 2/2 | 8 | 2917 | 4975 |
 realtime-gemini-2.5-flash-native-audio-preview-12-2025 | 1/2 | 0/2 | 2 | 4508 | 11117 |
realtime-gpt-live-1 | WAV 6/8 | 2/2 | 8 | 1550 | 5698 |
half_cascade-gpt-realtime-mini | 0/0 | 0/2 | 0 | N/A | N/A |
realtime-gemini-3.1-flash-live-preview | 0/0 | 0/2 | 0 | N/A | N/A |
realtime-gemini-3.8-live | 0/0 | 0/2 | 0 | N/A | N/A |
realtime-gemini-3.8-live-extended-thinking | 0/0 | 0/2 | 0 | N/A | N/A |
realtime-gpt-realtime-mini | 0/0 | 0/2 | 0 | N/A | N/A |
GPT Realtime 2.1 completó los ocho hechos de servicio comprobados. La media cascada con GPT Realtime 2.1 y GPT Realtime 2 alcanzaron 7/8. Sus contrapartes Mini alcanzaron 6/8. Los tiempos permanecen visibles cuando una tarea falla en su comprobación de calidad. Un turno fallido rápido no se cuenta como un resultado exitoso.
Las suites de Gemini y Realtime Mini más antiguas se detuvieron después de perder llamadas de herramientas coincidentes o continuación audible. No se intentaron tareas posteriores. Por lo tanto, una entrada 0/0 significa que no hay comprobaciones de tareas evaluables. No significa una calidad perfecta ni cuatro fallos probados por idioma. Se necesita más trabajo para aislar la ruta, la secuencia de eventos y el comportamiento de continuación.
Para el dúplex completo con GPT Live 1, ambas celdas de idioma tuvieron recibos de herramientas correctos. El reconocimiento independiente de los archivos WAV recibidos confirmó seis de los ocho hechos hablados: la respuesta de política alemana carecía del hecho de los 14 días, y el inglés carecía de la confirmación de reserva. Las transcripciones directas del modelo estaban incompletas. La comprobación WAV se muestra por separado en lugar de tratarse como idéntica a las comprobaciones basadas en transcripciones. Esta suite de servicio aún necesita una cualificación de resultados audibles.
La traducción se evaluó por separado en DE→EN y EN→DE. Ambas entregaron audio y conservaron la fecha, la hora y las entidades de Berlín. Un sustantivo alemán permaneció ambiguo en el reconocimiento independiente. Dos direcciones no establecen una tasa amplia de calidad de traducción. Un inicio de transmisión negativo representa superposición, no un tiempo de respuesta reactivo negativo.
6. LLM: los 33 modelos en el perfil de decisión
Modelo | Comprobaciones | No vacío | n | P50 ms | P95 ms |
|---|---|---|---|---|---|
google/gemma-4-31b-it | 16/16 | 16 | 16 | 162 | 535 |
openai/gpt-4.1 | 16/16 | 16 | 16 | 339 | 440 |
openai/gpt-4o | 16/16 | 16 | 16 | 389 | 890 |
openai/gpt-5.4-mini | 16/16 | 16 | 16 | 411 | 513 |
 deepseek-ai/deepseek-v4.1-flash | 16/16 | 16 | 16 | 494 | 821 |
openai/gpt-5.1 | 16/16 | 16 | 16 | 527 | 633 |
openai/gpt-5.6-luna | 16/16 | 16 | 16 | 561 | 1664 |
openai/gpt-5.2 | 16/16 | 16 | 16 | 575 | 663 |
openai/gpt-5.4 | 16/16 | 16 | 16 | 591 | 689 |
openai/gpt-5.6-sol | 16/16 | 16 | 16 | 654 | 2635 |
google/gemini-3.5-flash-lite | 16/16 | 16 | 16 | 698 | 1213 |
google/gemini-3.1-flash-lite | 16/16 | 16 | 16 | 707 | 4930 |
google/gemini-3.6-flash | 16/16 | 16 | 16 | 743 | 1362 |
google/gemini-3-flash-preview | 16/16 | 16 | 16 | 928 | 1180 |
google/gemini-3.5-flash | 16/16 | 16 | 16 | 1017 | 3469 |
openai/gpt-6-luna | 16/16 | 16 | 16 | 1145 | 2434 |
openai/gpt-5.5 | 16/16 | 16 | 16 | 1235 | 2645 |
xai/grok-4.7 | 16/16 | 16 | 16 | 5860 | 14607 |
openai/gpt-4.1-mini | 15/16 | 16 | 16 | 316 | 393 |
openai/gpt-5.6-terra | 15/16 | 15 | 15 | 576 | 827 |
xai/grok-4.20-0309-reasoning | 15/16 | 15 | 15 | 7864 | 17818 |
openai/gpt-5.4-nano | 14/16 | 15 | 15 | 400 | 520 |
google/gemini-3.7-flash | 13/16 | 16 | 16 | 2440 | 7146 |
xai/grok-4.20-multi-agent-0309 | 12/16 | 14 | 14 | 9672 | 19539 |
google/gemini-3.8-flash | 11/16 | 16 | 16 | 2625 | 10380 |
openai/gpt-4.1-nano | 10/16 | 16 | 16 | 284 | 364 |
openai/gpt-4o-mini | 10/16 | 16 | 16 | 345 | 740 |
xai/grok-4.20-0309-non-reasoning | 7/16 | 16 | 16 | 1070 | 6367 |
openai/gpt-5 | 5/16 | 6 | 6 | 2885 | 5624 |
google/gemini-3.1-pro-preview | 3/16 | 16 | 16 | 3697 | 6223 |
openai/gpt-5-mini | 0/16 | 1 | 1 | 2941 | 2941 |
openai/chat-latest | 0/16 | 0 | 0 | N/A | N/A |
openai/gpt-5-nano | 0/16 | 0 | 0 | N/A | N/A |
Cada modelo recibió 16 decisiones estructuradas breves, con un límite de salida original de 256 tokens. Las comprobaciones cubrieron hechos de referencia, acciones esperadas y rechazo de acciones no admitidas o prohibidas. La tabla separa las comprobaciones de decisión, las salidas no vacías y las muestras de tiempo. P50 y P95 utilizan solo observaciones con tiempos disponibles.
16/16 es una puerta de entrada aproximada con este tamaño de muestra. Incluso bajo una suposición binomial independiente simplificada, el límite inferior de Wilson del 95% es de aproximadamente el 80,6%. Estos casos fijos tampoco son una muestra aleatoria de las solicitudes de los clientes. Por lo tanto, el intervalo no proporciona una garantía de producción.
Las nuevas comprobaciones de GPT-5 utilizando un margen de 1.536 tokens mejoraron las respuestas no vacías. Utilizan un presupuesto diferente y no reemplazan silenciosamente la línea base de 256 tokens. Cuando un modelo de razonamiento consume su margen antes de producir una salida, examina la configuración. Una salida vacía o un error de ruta HTTP 400 no establecen una incapacidad intrínseca para responder a la pregunta del cliente.
Gemma 4 y otros candidatos de 16/16 como GPT-4.1, GPT-4o, GPT-5.4 Mini y DeepSeek V4.1 Flash son puntos de partida sensatos. Continúa con contextos más largos, argumentos de herramientas reales, correcciones y conversaciones de varios pasos. Un pequeño filtro de decisiones no reemplaza esa segunda etapa.
7. STT: voz humana y referencias suministradas
El filtro de precisión utiliza 16 grabaciones humanas de Google FLEURS. El alemán y el inglés se puntúan por separado. Cada candidato dentro de un idioma recibe los mismos archivos y textos de referencia. La selección contiene 82,56 segundos de alemán y 54,14 segundos de inglés, con 161 y 124 palabras de referencia respectivamente.
Alemán: resultados completos y calificados por separado
Modelo | Perfil | Clips | Palabras | Ediciones | WER | Calificación |
|---|---|---|---|---|---|---|
elevenlabs/scribe_v2_realtime | credential_or_eof_recheck | 8/8 | 161 | 1 | 0.62% | corpus corto completo |
google/gemini-3.5-transcribe-live | baseline | 8/8 | 161 | 2 | 1.24% | corpus corto completo |
 assemblyai/u3-rt-pro | baseline | 8/8 | 161 | 3 | 1.86% | corpus corto completo |
assemblyai/universal-3-5-pro | baseline | 8/8 | 161 | 3 | 1.86% | corpus corto completo |
assemblyai/universal-3-6-pro | baseline | 8/8 | 161 | 3 | 1.86% | corpus corto completo |
 speechmatics/linden-1 | baseline | 8/8 | 161 | 4 | 2.48% | corpus corto completo |
stt-rt-v5 | credential_or_eof_recheck | 8/8 | 161 | 6 | 3.73% | corpus corto completo |
xai/stt-1 | baseline | 8/8 | 161 | 6 | 3.73% | corpus corto completo |
xai/stt-2 | baseline | 8/8 | 161 | 6 | 3.73% | corpus corto completo |
deepgram/nova-3 | baseline | 8/8 | 161 | 7 | 4.35% | corpus corto completo |
deepgram/flux-general-multi | baseline | 8/8 | 161 | 10 | 6.21% | corpus corto completo |
deepgram/nova-2 | baseline | 8/8 | 161 | 12 | 7.45% | corpus corto completo |
cartesia/ink-whisper | baseline | 8/8 | 161 | 13 | 8.07% | corpus corto completo |
 solaria-1 | gladia_protocol_recheck | 5/8 | 112 | 7 | 6.25% | parcial; sin clasificar |
assemblyai/universal-streaming-multilingual | baseline | 8/8 | 161 | 176 | 109.32% | artefacto final duplicado; sin clasificar |
Inglés: resultados completos y calificados por separado
Modelo | Perfil | Clips | Palabras | Ediciones | WER | Calificación |
|---|---|---|---|---|---|---|
assemblyai/u3-rt-pro | línea base | 8/8 | 124 | 3 | 2.42% | corpus corto completo |
assemblyai/universal-3-5-pro | línea base | 8/8 | 124 | 3 | 2.42% | corpus corto completo |
assemblyai/universal-3-6-pro | línea base | 8/8 | 124 | 3 | 2.42% | corpus corto completo |
cartesia/ink-2 | línea base | 8/8 | 124 | 3 | 2.42% | corpus corto completo |
elevenlabs/scribe_v2_realtime | credential_or_eof_recheck | 8/8 | 124 | 4 | 3.23% | corpus corto completo |
deepgram/flux-general-en | línea base | 8/8 | 124 | 8 | 6.45% | corpus corto completo |
google/gemini-3.5-transcribe-live | línea base | 8/8 | 124 | 9 | 7.26% | corpus corto completo |
stt-rt-v5 | credential_or_eof_recheck | 8/8 | 124 | 10 | 8.06% | corpus corto completo |
speechmatics/linden-1 | línea base | 8/8 | 124 | 10 | 8.06% | corpus corto completo |
deepgram/flux-general-multi | línea base | 8/8 | 124 | 12 | 9.68% | corpus corto completo |
deepgram/nova-3 | línea base | 8/8 | 124 | 14 | 11.29% | corpus corto completo |
deepgram/nova-3-pharma | línea base | 8/8 | 124 | 16 | 12.90% | corpus corto completo |
deepgram/nova-2-conversationalai | línea base | 8/8 | 124 | 17 | 13.71% | corpus corto completo |
deepgram/nova-2-medical | línea base | 8/8 | 124 | 18 | 14.52% | corpus corto completo |
deepgram/nova-2-phonecall | línea base | 8/8 | 124 | 18 | 14.52% | corpus corto completo |
deepgram/nova-3-medical | línea base | 8/8 | 124 | 18 | 14.52% | corpus corto completo |
deepgram/nova-2 | línea base | 8/8 | 124 | 20 | 16.13% | corpus corto completo |
solaria-1 | gladia_protocol_recheck | 4/8 | 51 | 3 | 5.88% | parcial; sin clasificar |
cartesia/ink-whisper | línea base | 6/8 | 99 | 29 | 29.29% | parcial; sin clasificar |
xai/stt-1 | línea base | 6/8 | 99 | 33 | 33.33% | parcial; sin clasificar |
xai/stt-2 | línea base | 6/8 | 99 | 33 | 33.33% | parcial; sin clasificar |
assemblyai/universal-streaming | línea base | 8/8 | 124 | 84 | 67.74% | artefacto final duplicado; sin clasificar |
assemblyai/universal-streaming-multilingual | línea base | 7/8 | 114 | 120 | 105.26% | artefacto final duplicado; sin clasificar |
El Micro WER es la suma de sustituciones, eliminaciones e inserciones dividida por el total de palabras de referencia. No es el promedio de ocho porcentajes a nivel de clip. Una edición adicional cambia el WER en alemán en aproximadamente 0,62 puntos porcentuales y en inglés en unos 0,81 puntos. Combinar DE y EN daría más peso al alemán debido a su mayor recuento de palabras.
Los corpus parciales se identifican por separado. Su WER describe solo los clips evaluados con éxito y no puede clasificarse de manera justa frente a los corpus completos. Las transcripciones faltantes no equivalen a un reconocimiento libre de errores. Los resultados de AssemblyAI Universal Streaming con hipótesis finales duplicadas también quedan fuera del orden comparativo. El WER puede superar el 100% cuando se insertan muchas palabras adicionales. El manejo de segmentos y formateadores requiere una calificación antes de interpretar esos artefactos como calidad de reconocimiento.
La selección proviene de la división de validación y contiene discurso leído. Las grabaciones en alemán tienen metadatos masculinos; el inglés tiene cuatro entradas masculinas y cuatro femeninas. Esto no representa una cobertura exhaustiva de acentos, habla espontánea, ruido o telefonía. Tampoco establece identidades de hablante distintas. Añade tus propios nombres, identificadores de cliente, horarios, términos de producto y audio telefónico antes de la aceptación.
8. TTS: los 29 modelos y el primer fragmento de audio
Modelo | Perfil | Audio | P50 ms | P95 ms |
|---|---|---|---|---|
eleven_v3_conversational | línea base | 8/8 | 125 | 702 |
elevenlabs/eleven_v4_turbo | línea base | 8/8 | 129 | 141 |
elevenlabs/eleven_flash_v2_5 | línea base | 8/8 | 138 | 1265 |
elevenlabs/eleven_turbo_v2_5 | línea base | 8/8 | 179 | 225 |
cartesia/sonic-latest | línea base | 8/8 | 182 | 231 |
cartesia/sonic-3.6-2026-08-27 | línea base | 8/8 | 186 | 222 |
cartesia/sonic-preview | línea base | 8/8 | 187 | 231 |
gradium/default | línea base | 8/8 | 192 | 264 |
cartesia/sonic-3.6 | línea base | 8/8 | 197 | 205 |
cartesia/sonic-3-latest | línea base | 8/8 | 217 | 1274 |
cartesia/sonic-3.5 | línea base | 8/8 | 219 | 250 |
cartesia/sonic-3.5-2026-05-04 | línea base | 8/8 | 236 | 243 |
cartesia/sonic-3 | línea base | 8/8 | 238 | 325 |
cartesia/sonic-3-2026-01-12 | línea base | 8/8 | 260 | 293 |
inworld/inworld-tts-2-flash | línea base | 8/8 | 338 | 676 |
inworld/inworld-tts-1.5-mini | línea base | 8/8 | 357 | 578 |
inworld/inworld-tts-2 | línea base | 8/8 | 359 | 654 |
inworld/inworld-tts-1.5-max | línea base | 8/8 | 415 | 454 |
deepgram/aura-2 | línea base | 8/8 | 476 | 762 |
elevenlabs/eleven_v3 | línea base | 8/8 | 487 | 766 |
deepgram/flux-tts | flux_model_voice_recheck | 4/4 | 538 | 740 |
rime/coda | línea base | 8/8 | 601 | 637 |
elevenlabs/eleven_v4 | línea base | 8/8 | 638 | 775 |
soniox/tts-rt-v2 | credential_or_eof_recheck | 8/8 | 718 | 771 |
elevenlabs/eleven_multilingual_v2 | línea base | 8/8 | 868 | 1920 |
xai/tts-1 | línea base | 8/8 | 876 | 949 |
fishaudio/s2.1-pro | línea base | 8/8 | 1191 | 1758 |
fishaudio/s2-pro | línea base | 8/8 | 1237 | 1317 |
gpt-4o-mini-tts | línea base | 3/8 | 1154 | 1550 |
Cada idioma utiliza cuatro frases cortas fijas y una voz fija. El TTFB local se mide desde el inicio de la solicitud de fábrica/proveedor hasta el primer fragmento PCM. Termina antes de la respuesta audible del interlocutor. Es una medición de componentes, no un tiempo de conversación completo.
Eleven v3 Conversational, Eleven v4 Turbo, Flash, las configuraciones recientes de Cartesia y Gradium fueron candidatos rápidos en este perfil. Su orden puede cambiar en una tubería completa. Deepgram Aura-2, por ejemplo, mostró un tiempo de componente local superior al de varios modelos, mientras que la tubería completa de Deepgram tuvo uno de los tiempos de confirmación del interlocutor más bajos. Los límites, el texto generado y las rutas de transmisión difieren.
Flux TTS se revisó con su voz Alexis compatible en cuatro frases en inglés. Esa revisión solo en inglés es explícitamente distinta de las filas de línea base bilingües. GPT-4o Mini TTS devolvió tres de las ocho muestras de línea base; sus tiempos cubren esas tres salidas disponibles en lugar de ocho respuestas exitosas.
Ningún jurado a ciegas calificó la naturalidad, la pronunciación o la preferencia de voz. Escucha tu lista de candidatos usando tu vocabulario: nombres personales y de empresa, direcciones de correo electrónico, decimales, horarios, abreviaturas y cambios de idioma. Juzga la inteligibilidad antes que la adecuación de la marca. Un primer fragmento rápido no mide ninguna de las dos cosas.
9. Bandas de coste: Bajo, Medio y Alto
Tubería | Banda de coste | Evidencia |
|---|---|---|
Gradium | Alto | Cuota conocida de LLM/TTS; coste total sin resolver |
Deepgram | Medio | Cuota conocida de LLM/TTS; coste total sin resolver |
Cartesia | Alto | Cuota conocida de LLM/TTS; coste total sin resolver |
ElevenLabs | Sin resolver | Falta tarifa de TTS o cantidades de facturación |
Rime | Medio | Cuota conocida de LLM/TTS; coste total sin resolver |
Inworld | Bajo | Cuota conocida de LLM/TTS; coste total sin resolver |
Soniox | Sin resolver | Falta tarifa de TTS o cantidades de facturación |
Fish Audio | Bajo | Cuota conocida de LLM/TTS; coste total sin resolver |
xAI | Bajo | Cuota conocida de LLM/TTS; coste total sin resolver |
Estas bandas describen solo la cuota de inferencia conocida de LLM/TTS relativa para siete pares de tuberías comparables. Cada par utiliza las dos llamadas DE/EN completadas, excluye pilotos y tiene cantidades atribuibles de LLM y TTS con tarifas públicas referenciadas. Ordena los siete subtotales conocidos: los tres primeros reciben Bajo, los dos siguientes Medio y los dos últimos Alto. Las bandas son relativas a este experimento, no a los niveles de plan de Famulor.
Faltan o no están completamente atribuidas las cantidades de tokens de STT, el uso de algunos detectores, el transporte, la infraestructura, la grabación, los descuentos y los costes de factura. La tarifa exacta de Eleven v4 Turbo no está disponible; a Soniox le faltan cantidades de facturación coincidentes. Ambos permanecen sin resolver. Los modos nativos no se insertan en estas bandas de tubería. Las longitudes de respuesta, los saludos y las respuestas a interrupciones también afectan a las cuotas conocidas.
Bajo no significa la pila completa más barata. Alto no significa una tarifa alta de Famulor. Las bandas ayudan a interpretar una parte comparable del uso de prueba registrado. El coste real por llamada de cliente resuelta requiere una atribución de costes completa y resultados de negocio verificados. Este informe no publica importes monetarios internos.
10. Cuatro flujos de trabajo y sus preguntas de aceptación
Flujo de trabajo | Verificación clave | Siguiente cualificación |
|---|---|---|
Servicio | Política e identificador | Incertidumbre y transferencia confirmada |
Reservas | Ranura, zona horaria, una acción | Verificar estado persistente del calendario |
Ventas | Hechos y cualificación | Ofertas desconocidas y detalles faltantes |
Soporte | Pasos y protección por contraseña | Corrección, error de herramienta, interrupción |
Las tablas de flujo de trabajo muestran las observaciones en ambos idiomas como un rango. Cada combinación tiene una tarea positiva por idioma. La observación más baja no es una mediana fiable del sector. Solo aparecen los pares de tareas superadas. Estas diferencias no pueden establecer a un ganador en calidad especializada para atención al cliente o ventas.
Atención al cliente
Configuración | Turnos verificados | ms inferior | ms superior |
|---|---|---|---|
pipeline-gradium | 2 | 779 | 1095 |
pipeline-rime | 2 | 874 | 1261 |
pipeline-inworld | 2 | 881 | 1185 |
pipeline-soniox | 2 | 1001 | 1350 |
pipeline-cartesia | 2 | 1049 | 1204 |
pipeline-deepgram | 2 | 1178 | 1308 |
pipeline-elevenlabs | 2 | 1250 | 1261 |
pipeline-fishaudio | 2 | 1284 | 1530 |
pipeline-xai | 2 | 1445 | 3054 |
half_cascade-gpt-realtime-2.1-mini | 2 | 1471 | 1551 |
half_cascade-gpt-realtime-2.1 | 2 | 1780 | 1994 |
half_cascade-gpt-realtime-2 | 2 | 1990 | 2320 |
realtime-gpt-realtime-2.1-mini | 2 | 2157 | 2260 |
realtime-gpt-realtime-2 | 2 | 2400 | 2496 |
realtime-gpt-realtime-2.1 | 2 | 2677 | 2710 |
Comprueba políticas aprobadas, identificadores, correcciones y solicitudes de una persona. La tarea controlada verificó un hecho de política conocido y su recibo de confirmación. Un conjunto de aceptación real también necesita información incompleta, solicitudes contradictorias y transferencias confirmadas.
Reserva de citas
Configuración | Turnos verificados | ms inferior | ms superior |
|---|---|---|---|
pipeline-gradium | 2 | 1128 | 1272 |
pipeline-elevenlabs | 2 | 1168 | 1326 |
pipeline-deepgram | 2 | 1186 | 1360 |
pipeline-cartesia | 2 | 1241 | 1352 |
pipeline-rime | 2 | 1244 | 1480 |
pipeline-inworld | 2 | 1269 | 1392 |
pipeline-soniox | 2 | 1400 | 1616 |
pipeline-fishaudio | 2 | 1481 | 1610 |
pipeline-xai | 2 | 1555 | 1582 |
realtime-gpt-realtime-2.1 | 2 | 2658 | 2688 |
El objetivo es la ranura ofrecida correcta, incluyendo fecha, hora y zona horaria. Inspecciona el estado real del calendario de prueba tras la reserva. Requiere exactamente una acción persistida y una confirmación hablada coincidente. Añade ranuras no disponibles, aclaraciones, reprogramaciones y entrega repetida de herramientas para detectar reservas duplicadas.
Ventas
Configuración | Turnos verificados | ms inferior | ms superior |
|---|---|---|---|
pipeline-gradium | 2 | 1167 | 1250 |
pipeline-deepgram | 2 | 1174 | 1425 |
pipeline-rime | 2 | 1232 | 1469 |
pipeline-cartesia | 2 | 1239 | 1292 |
pipeline-elevenlabs | 2 | 1247 | 1257 |
pipeline-inworld | 2 | 1249 | 1359 |
pipeline-soniox | 2 | 1429 | 1509 |
pipeline-fishaudio | 2 | 1521 | 1540 |
pipeline-xai | 2 | 1664 | 1731 |
half_cascade-gpt-realtime-2.1 | 2 | 1827 | 1990 |
half_cascade-gpt-realtime-2 | 2 | 1878 | 2485 |
realtime-gpt-realtime-2.1-mini | 2 | 2128 | 3026 |
realtime-gpt-realtime-2.1 | 2 | 2537 | 2616 |
realtime-gpt-realtime-2 | 2 | 4728 | 4975 |
Las comprobaciones cubrieron hechos fijos del producto y la acción esperada. La siguiente etapa necesita solicitudes inciertas, detalles faltantes y ofertas no aprobadas. Los hechos sobre precios y plazas en los accesorios eran datos de prueba ficticios. No son precios de Famulor y no se reproducen como ofertas comerciales.
Soporte técnico
Configuración | Turnos verificados | ms inferior | ms superior |
|---|---|---|---|
pipeline-deepgram | 2 | 1201 | 1268 |
pipeline-gradium | 2 | 1205 | 1209 |
pipeline-elevenlabs | 2 | 1237 | 1318 |
pipeline-inworld | 2 | 1269 | 1318 |
pipeline-cartesia | 2 | 1319 | 1371 |
pipeline-rime | 2 | 1430 | 1499 |
pipeline-soniox | 2 | 1478 | 1487 |
pipeline-fishaudio | 2 | 1539 | 1590 |
pipeline-xai | 2 | 1562 | 1580 |
half_cascade-gpt-realtime-2.1 | 2 | 1889 | 2206 |
half_cascade-gpt-realtime-2.1-mini | 2 | 1899 | 2541 |
half_cascade-gpt-realtime-2 | 2 | 2346 | 2444 |
realtime-gpt-realtime-2.1 | 2 | 2354 | 2895 |
realtime-gpt-realtime-2.1-mini | 2 | 2406 | 12913 |
realtime-gpt-realtime-2 | 2 | 2476 | 2954 |
El caso controlado utilizó un código de error conocido, una secuencia de pasos fija y protección por contraseña. Añade pasos fallidos, información nueva y una interrupción a mitad de las instrucciones. La recuperación correcta aborda la solicitud modificada en lugar de continuar con el párrafo anterior.
11. Lectura de tiempos en el límite correcto
Métrica | Inicio → fin | Significado |
|---|---|---|
Proxy de confirmación | Fin de la llamada → audio tras la recepción | Inicio del audio, no una marca de tiempo de palabra |
TTFT del LLM | Solicitud → primer token de texto | Tiempo de inicio del componente |
TTFB del TTS | Fábrica → primer fragmento PCM | Componente, no audio de la llamada |
EOT | Fin detectado → decisión de turno | Valor del SDK; se requiere comprobación de límite independiente |
Micro WER | (S + D + I) / N | Ediciones de palabras por palabra de referencia |
P50 / P95 | Rango más cercano | Mostrar siempre n y perfil |
Las tablas utilizan percentiles de rango más cercano: ordena las observaciones y selecciona la posición ceil(p × n). Con n=8, P95 es la mayor de ocho observaciones. Describe el turno medido más lento en esa muestra. Un P95 de producción estable necesita un conjunto de datos sustancialmente mayor y estratificado adecuadamente.
Los turnos dentro de una llamada comparten configuración y condiciones de red. Ocho turnos no son ocho llamadas de cliente independientes. Los intervalos de confianza y las repeticiones deben respetar la llamada como una unidad compartida. Agrupar turnos puede sugerir más certeza de la que admite el experimento.
Métricas del trabajador de la canalización exportadas
Canalización | LLM n/P50/P95 | TTS n/P50/P95 | EOT n/P50/P95 |
|---|---|---|---|
pipeline-cartesia | 12 / 149 / 175 | 13 / 67 / 120 | 12 / 578 / 582 |
pipeline-deepgram | 12 / 148 / 159 | 13 / 137 / 884 | 12 / 578 / 579 |
pipeline-elevenlabs | 12 / 148 / 179 | 14 / 84 / 93 | 12 / 578 / 580 |
pipeline-fishaudio | 12 / 144 / 155 | 12 / 466 / 1344 | 12 / 578 / 579 |
pipeline-gradium | 12 / 145 / 159 | 14 / 90 / 149 | 12 / 578 / 580 |
pipeline-inworld | 13 / 146 / 204 | 13 / 186 / 309 | 12 / 578 / 580 |
pipeline-rime | 12 / 146 / 182 | 14 / 235 / 549 | 12 / 578 / 579 |
pipeline-soniox | 13 / 148 / 163 | 15 / 309 / 404 | 12 / 578 / 580 |
pipeline-xai | 12 / 145 / 157 | 12 / 418 / 745 | 12 / 578 / 2501 |
Dependiendo de la exportación, estas métricas del SDK incluyen saludos, continuaciones de herramientas y respuestas a interrupciones. Sus recuentos de muestra difieren de las ocho tareas controladas. Los valores P50 de los componentes no se pueden sumar para derivar el P50 de la conversación: las líneas de tiempo se superponen y los conjuntos de observación difieren.
12. Lo que necesita un informe completo
Métrica | Evidencia aquí | Evidencia adicional necesaria |
|---|---|---|
Comprobación de herramienta/hecho | Recibos ficticios + hechos hablados | Estado de acción real |
Tasa de resolución | Sin medir | Resultados reales etiquetados y denominador |
Tasa de alucinación | Comprobaciones de hechos fijos/rechazos | Anotación independiente de reclamaciones materiales |
Transferencia | Sin prueba de aceptación telefónica nueva | Destino aprobado y recogida verificada |
Tasa de abandono | Observación de desconexión acotada | Observaciones completas de ambos pares |
Naturalidad | Sin jurado de oyentes ciego | Pruebas de oyentes con guiones idénticos |
Coste por resolución | Sin medir | Costes completos y resolución real |
Una llamada técnicamente completada no es un caso de cliente resuelto verificado. Una orden de transferencia aceptada no prueba la recogida humana. Una declaración hablada coincidente no prueba una acción persistida. El informe debe registrar estos estados por separado y conectarlos con la tarea esperada.
Para cada caso, retén el idioma, la configuración, la versión de la herramienta/prompt, la ruta del modelo, la hora, la acción esperada, el recibo recibido y el resultado hablado. Mantén separados los estados Pasado, Fallido, No intentado y No resuelto. Dale a cada métrica su denominador adecuado. Una buena observación de tiempos sigue siendo útil sin ocultar un resultado fallido.
Los agregados de producción históricos de la semana anterior fueron evidencia operativa adicional. Están excluidos del orden controlado porque los clientes, las tareas, los ajustes y las versiones diferían. Eso evita que los datos de operaciones observacionales se conviertan en una comparación de modelos causales.
13. Utiliza la API de Famulor para comprobaciones reproducibles
Propósito | Contrato de API | Uso |
|---|---|---|
Catálogo | GET /user/assistants/models | Registrar IDs de modelos disponibles |
Voces | GET /user/assistants/voices | Fijar voz e idioma |
Proveedores | GET /user/assistants/transcriber-providers | Registrar ruta STT |
Probar asistente | POST /user/assistant | Configuración de prueba aislada |
Llamada | GET /user/calls/{id} | Unir datos y resultado de la llamada |
Post-llamada | Webhook | Transcripción, variables y grabación |
El archivo OpenAPI suministrado describe el contrato de la API del producto. No proporciona resultados de referencia ni una puntuación de calidad predefinida. Utiliza los endpoints del catálogo para registrar los modelos y voces disponibles en el momento de la prueba. Configura un asistente de prueba independiente y una herramienta con respuestas controladas. Realiza una llamada de prueba real solo con un destino aprobado.
La recuperación de llamadas y los webhooks post-llamada conectan la información de la llamada documentada, las transcripciones, las variables extraídas y las referencias de grabación. Las mediciones de fin de habla, inicio de audio, recepción de herramientas e interrupción en milisegundos requieren una instrumentación adicional de la ruta de voz. La duración y el estado de la llamada son insuficientes. No reclames campos TTFT, TTFB o WER a menos que tu contrato de respuesta real los proporcione.
La autenticación utiliza un token Bearer del lado del servidor. Mantén las credenciales, los números de cliente, las grabaciones privadas y los importes internos fuera de los informes públicos. Las tablas agregadas, los casos claros y las pruebas redactadas son adecuados para compartir.
14. Convierte la lista corta en un plan de aceptación
Especifica la acción prevista, la confirmación audible y la respuesta permitida ante la incertidumbre para cada flujo de trabajo.
Elige varios candidatos totalmente verificados. Mantén constantes el prompt, el conocimiento, las respuestas de las herramientas, la región y el audio de quien llama.
Repite los casos en orden aleatorio. Separa los arranques en frío de los cálidos. Conserva todos los intentos fallidos.
Añade habla espontánea, voces variadas, códecs telefónicos, ruido, pausas, correcciones y pérdida de paquetes.
Comprueba el estado real del sistema de prueba, como una reserva de calendario. Evalúa de forma independiente tanto el audio recibido como las transcripciones del modelo.
Establece umbrales de calidad y tiempo antes de la prueba. Decide utilizando esos umbrales y la incertidumbre en lugar de una puntuación ganadora ponderada retrospectivamente.
Vuelve a ejecutar la aceptación tras realizar cambios en el prompt, las herramientas, la ruta o el motor. Conserva los resultados de la regresión con las versiones correspondientes.
Las simulaciones de Famulor proporcionan un punto de partida para comprobaciones de flujo de trabajo repetibles. Añade pruebas integrales habladas cuando los clientes escuchen audio y puedan interrumpir las respuestas. Los escenarios de simulación creados son plantillas; su presencia no demuestra una evaluación ejecutada adicional.
15. Elige tu primera configuración
Para tareas de servicio breves basadas en hechos fijos de herramientas, una canalización es el punto de partida más sólido en este cribado. Comienza con Gemma 4 y un STT adecuado al idioma. Compara varias voces exitosas, especialmente Gradium, Deepgram, Cartesia y ElevenLabs, utilizando tus nombres y números críticos. Trata las bandas de costes como observaciones parciales suplementarias.
Para una comprensión de audio nativa combinada con una voz externa específica, califica Half-Cascade. Para respuestas habladas nativas, GPT Realtime 2.1 es un candidato de esta pequeña suite completada. Para Full Duplex, céntrate en el habla superpuesta y en resultados audibles completos. Tu flujo de trabajo y tus criterios de aceptación determinarán la elección.
16. Fuentes y reproducibilidad
La fuente de medición principal es la instantánea de investigación de Famulor con fecha del 13 de octubre de 2026. Las tablas utilizan sus resultados finales corregidos; las notas de revisión anteriores no prevalecen sobre los resultados posteriores. Los importes monetarios, los IDs de llamadas privadas y las credenciales están excluidos de esta edición pública.
Google FLEURS: Ficha del conjunto de datos. Grabaciones humanas y transcripciones suministradas, CC BY 4.0.
Conneau et al.: FLEURS, 2022. Descripción del corpus.
Creative Commons BY 4.0. Licencia y atribución.
NIST: Métricas ASR. Interpretación de la tasa de error de palabras.
LiveKit: Métricas de agente. Métricas de SDK y límites de medición.
Documentación de la API de Famulor. API de producto y eventos.
La selección de FLEURS utiliza de_de y en_us, validación, revisión 70bb2e84b976b7e960aa89f1c648e09c59f894dd. Filas en alemán: 0, 1, 2, 3, 5, 6, 8, 201. Filas en inglés: 0, 2, 3, 4, 5, 6, 7, 8. El audio se convirtió a PCM16 mono a 16 kHz, con esa modificación registrada. Los autores y locutores del corpus no respaldan este informe. Las referencias normalizadas y los eventos individuales pertenecen a un registro de reproducción.
Compara modos del motor Famulor, escucha en la biblioteca de voces y planifica tu configuración de prueba. Reserva una demostración.
Autor en Famulor