Resumir contenido con:




La cuestión del modelo en la IA de voz parece técnica al principio: ¿qué LLM debería utilizar el agente telefónico? Sin embargo, en producción, el nombre del modelo por sí solo no determina la calidad de la conversación. Las empresas deben evaluar tres capas conjuntamente: la arquitectura de la conversación, el modelo de lenguaje y el proceso específico que el agente debe completar de forma fiable.
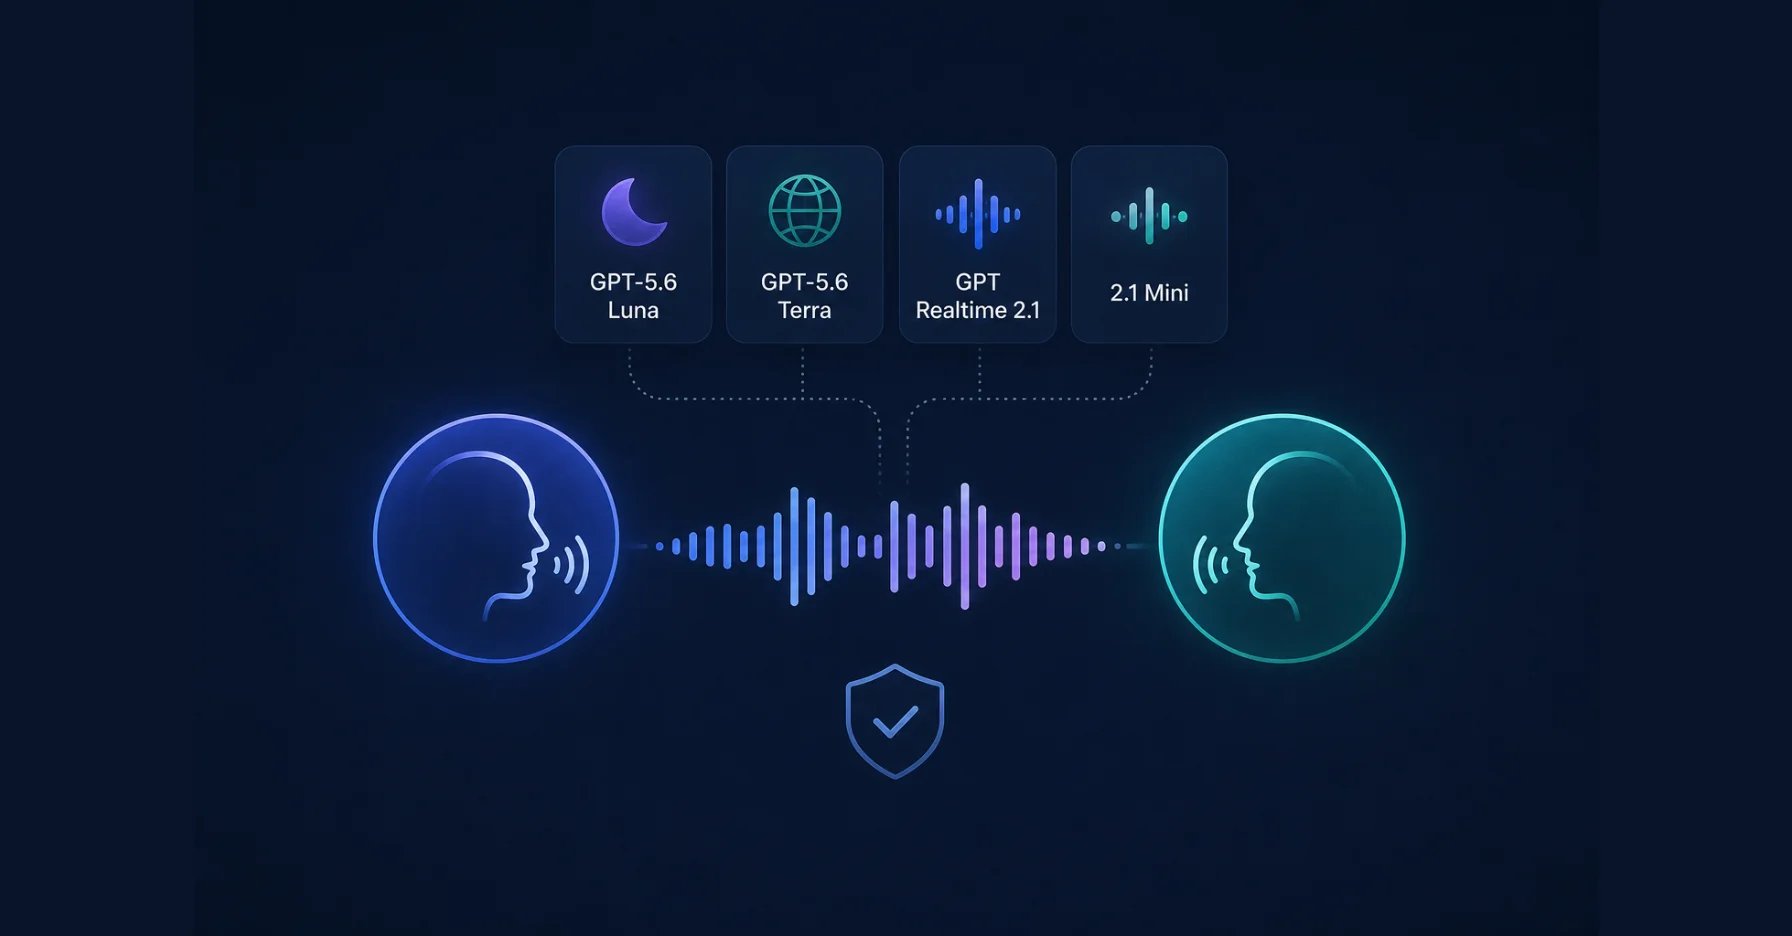
Famulor puso a disposición dos nuevas familias de modelos en julio de 2026: GPT-5.6 Luna y GPT-5.6 Terra en modo Pipeline, además de GPT Realtime 2.1 y GPT Realtime 2.1 Mini para speech-to-speech y Dualplex™. No se trata de una simple clasificación de “rápido” a “inteligente”. Es un kit de herramientas para diferentes requisitos operativos.
Esta guía muestra a los equipos de operaciones, CX e IT cómo tomar una decisión defendible utilizando casos de prueba, criterios de medición y un despliegue construido en torno a conversaciones reales en lugar de una demostración perfecta.
1. Elige la arquitectura antes que el modelo
Un error común en la adquisición es comparar modelos de forma aislada. En la IA de voz, la ruta de procesamiento importa tanto como el modelo. Famulor admite tres modos relevantes:
| Modo | Ruta de procesamiento | Modelos compatibles | Uso ideal |
|---|---|---|---|
| Pipeline | Speech-to-text → LLM → text-to-speech | GPT-5.6 Luna, GPT-5.6 Terra | Prompts complejos, datos estructurados, respuestas largas y voces de marca controladas |
| Speech-to-speech | Procesamiento de voz multimodal directo | GPT Realtime 2.1, GPT Realtime 2.1 Mini | Turnos de palabra rápidos, respuestas cortas y diálogo natural |
| Dualplex™ | Comprensión multimodal con salida de voz premium independiente | GPT Realtime 2.1, GPT Realtime 2.1 Mini | Baja latencia con una voz de marca premium o clonada |
La documentación de modos de asistente enumera rangos típicos de aproximadamente 800 a 1.500 milisegundos para Pipeline y de 300 a 600 milisegundos para speech-to-speech. Estos son valores orientativos: el idioma, el modelo, las condiciones de la red y las llamadas a herramientas afectan a la velocidad percibida. El objetivo práctico no es la cifra más pequeña de laboratorio, sino una conversación que se mantenga fluida y correcta durante todo el flujo de trabajo previsto.
2. Qué significan los nuevos modelos en la práctica
GPT-5.6 Luna y GPT-5.6 Terra: candidatos para cargas de trabajo exigentes en Pipeline
GPT-5.6 Luna y GPT-5.6 Terra están disponibles en el modo Pipeline de Famulor. Según el registro de cambios del producto Famulor, la nueva generación apunta a un razonamiento más preciso, un seguimiento de instrucciones más sólido y un manejo más natural de conversaciones largas y de varios pasos.
Para los equipos empresariales, un punto es clave: Famulor no declara actualmente un ganador universal entre Luna y Terra. Ese es el enfoque correcto. Un modelo que funciona bien en un soporte de primer nivel complejo no ganará automáticamente en un flujo de cualificación de citas conciso o en una captura de datos altamente estructurada. Trátalos a ambos como candidatos de lanzamiento y compáralos con los mismos casos de conversación reales.
GPT Realtime 2.1: conversación directa natural para interacciones exigentes
GPT Realtime 2.1 está disponible para asistentes speech-to-speech y Dualplex. Famulor describe una mayor adherencia a los prompts y un manejo más natural de nombres, números e interrupciones. Esto lo hace relevante cuando las conversaciones deben reaccionar rápidamente y, al mismo tiempo, capturar detalles críticos para el negocio, como números de cliente, direcciones, horas de citas o variantes de productos.
GPT Realtime 2.1 Mini: la opción más ligera para volumen
GPT Realtime 2.1 Mini se posiciona como una opción más ligera y rápida para asistentes de alto volumen o más sencillos. Los candidatos típicos incluyen comprobaciones de estado, recepción de devoluciones de llamada, cualificación breve, conversaciones de FAQ y procesos de reserva de alcance limitado. Pero “Mini” no debe confundirse con “siempre más barato en todo el proceso”. Si genera repeticiones frecuentes, clasificaciones erróneas o transferencias innecesarias, el coste operativo puede ser mayor.
3. Una matriz de decisión para procesos reales de IA de voz
| Requisito | Punto de partida | Por qué |
|---|---|---|
| Políticas complejas, múltiples fuentes de datos, explicaciones largas | Comparar Luna y Terra en Pipeline | Más control sobre el prompt, el procesamiento de texto y la salida de voz |
| Conversaciones de ventas o reservas cortas y dinámicas | Speech-to-speech con Realtime 2.1 | Turnos de palabra rápidos y reacciones naturales |
| Muy alto volumen de conversaciones sencillas | Realtime 2.1 Mini como base | Posicionado para cargas de trabajo más ligeras y rápidas |
| Voz de marca o clonada con baja latencia | Dualplex con Realtime 2.1 | Combina comprensión multimodal con salida de voz controlada |
| Divulgaciones o confirmaciones que deben decirse completas | Elegir el modo adecuado y desactivar interrupciones | Famulor ahora admite el ajuste en Pipeline, speech-to-speech y Dualplex |
La capacidad forma parte de la misma decisión. Planifica los minutos, la carga máxima y la concurrencia antes de convertir cualquier modelo en el estándar de producción.
Planifica minutos, picos y plan
Estima la capacidad de Voice AI necesaria y el plan que mejor encaja.
Famulor
Voice AI
Minutos AI mensuales
11.088
Plan recomendado
Agency
Llamadas pico simultáneas
3
Horas automatizadas
185
4. Un plan de pruebas empresarial de cinco pasos
Paso 1: Define el proceso como una cadena de resultados exitosos
No empieces con “el agente debe sonar natural”. Define una finalización medible: identidad confirmada, intención clasificada, registro CRM encontrado, cita reservada, confirmación enviada. Cada etapa necesita una condición de éxito clara y un plan de contingencia esperado.
Paso 2: Construye un conjunto de referencia (golden set) a partir de patrones de conversación reales
Crea un conjunto pequeño y representativo de situaciones anonimizadas. Incluye solicitudes comunes y casos difíciles:
- Nombres con ortografía inusual y términos que suenan parecido
- Números de teléfono, códigos postales, horas e IDs de pedido
- Interrupciones, autocorrecciones y ruido de fondo
- Solicitudes de varias partes que requieren preguntas de seguimiento
- Datos de CRM faltantes o franjas horarias de citas no disponibles
- Tiempos de espera de herramientas, respuestas no válidas y escalada humana segura
Paso 3: Prueba la arquitectura y el modelo por separado
Primero compara los modos con el mismo resultado de proceso. Luego compara los modelos dentro del modo más adecuado. Esto evita que los equipos atribuyan una ventaja de arquitectura a un modelo. Utiliza llamadas de prueba salientes, así como un número asignado para pruebas entrantes; la guía de pruebas de Famulor cubre ambos caminos.
Paso 4: Utiliza una tarjeta de puntuación ponderada
Una tarjeta de puntuación práctica puede cubrir cinco dimensiones:
- Éxito de la tarea: ¿El proceso terminó completa y correctamente?
- Precisión de los datos: ¿Se capturaron correctamente los nombres, números y campos requeridos?
- Adherencia a las instrucciones: ¿Respetó el agente los límites, el orden y las aprobaciones?
- Calidad de la conversación: ¿Fueron apropiados los turnos de palabra, el tono y las interrupciones?
- Calidad operativa: ¿Funcionaron las herramientas, transferencias, registros y reintentos como se esperaba?
Pondera la puntuación según el riesgo. La velocidad puede ser lo más importante en la reserva de citas; los datos de contrato o identidad deben priorizar la precisión y la escalada segura.
Paso 5: Dirige los modelos por proceso en lugar de forzar un valor predeterminado
Las grandes organizaciones rara vez necesitan un solo modelo para cada llamada. Un agente Realtime ligero puede capturar la intención y la urgencia, mientras que un agente Pipeline maneja un caso complejo. Diferentes asistentes para ubicaciones, idiomas o clases de riesgo también pueden utilizar diferentes configuraciones. El estándar operativo no es entonces “un modelo”, sino un enrutamiento controlado con umbrales de calidad compartidos.
5. Una actualización de modelo no sustituye a la gobernanza
Más razonamiento o un habla más natural no arreglan permisos poco claros. Define qué datos puede leer cada asistente, qué acciones puede ejecutar y cuándo se requiere la aprobación humana. Las acciones durante la llamada y las conexiones MCP solo deben recibir los sistemas y campos que necesitan. Prueba las acciones con parámetros antes de habilitarlas en conversaciones reales.
La minimización de datos, las reglas de retención y los registros trazables son igual de importantes. Los flujos de trabajo regulados o sensibles deben añadir una revisión de privacidad y riesgo al despliegue. Famulor proporciona infraestructura alemana, un DPA y procesos configurables, mientras que la organización que realiza el despliegue sigue siendo responsable de su uso específico.
6. Un despliegue de menor riesgo para Luna, Terra y Realtime 2.1
- Captura la línea base: documenta la tasa de finalización actual, la tasa de transferencia, los tipos de fallos y la latencia percibida.
- Ejecuta una prueba en sombra: valida la nueva configuración con casos históricos o simulados sin cambiar el tráfico de clientes.
- Empieza con un pequeño segmento en vivo: activa un proceso o ubicación claramente delimitado.
- Revisa diariamente: inspecciona las conversaciones fallidas, llamadas a herramientas, interrupciones y campos capturados.
- Escala solo tras una calidad estable: aumenta el volumen gradualmente y mantén una ruta de reversión rápida.
Una actualización de modelo debe tratarse como un cambio de producto operativo: hipótesis, prueba, aprobación y supervisión. Eso convierte la nueva capacidad en una calidad de proceso medible en lugar de otra entrada en un menú desplegable de modelos.
Prueba nuestro Asistente de IA
Experimenta lo natural que suena nuestro asistente telefónico de IA.
Introduce tus datos y recibe una llamada de nuestro agente de IA en segundos.
El agente está entrenado para hablar sobre los servicios de Famulor y programar citas.

Agente IA de demo
Representante de Famulor
Conclusión: el mejor modelo de IA de voz es específico para cada carga de trabajo
GPT-5.6 Luna y Terra amplían las opciones de Pipeline para conversaciones exigentes de varios pasos. GPT Realtime 2.1 apunta a una conversación directa natural con una mayor adherencia a los prompts; Realtime 2.1 Mini es una base sensata para procesos más sencillos de alto volumen. Dualplex combina un procesamiento multimodal rápido con una salida de voz premium controlada.
La selección correcta no proviene de una tabla de clasificación de modelos. Proviene de un proceso claro, un conjunto de pruebas representativo y una tarjeta de puntuación que mide los resultados empresariales, la calidad de los datos y la seguridad operativa conjuntamente. Es entonces cuando la selección del modelo se convierte en una decisión de arquitectura empresarial en lugar de una cuestión de gustos.
FAQ
¿Qué modelo de Famulor se ajusta a las conversaciones de soporte complejas?
Empieza con Pipeline y compara GPT-5.6 Luna y GPT-5.6 Terra con los mismos casos de soporte. Pipeline ofrece más control para datos estructurados, respuestas más largas y prompts complejos.
¿Cuándo es GPT Realtime 2.1 Mini la mejor opción?
Mini es una base sensata para conversaciones de alto volumen, muy delimitadas y más sencillas. Decide utilizando el coste total del proceso y las tasas de error, no solo el tamaño del modelo.
¿Puedo usar una voz clonada con baja latencia?
Dualplex es el punto de partida adecuado porque combina la comprensión multimodal con una salida de voz premium y controlada. Valida la voz, el idioma y el flujo de trabajo en una llamada de prueba.
¿Debería una empresa estandarizar solo un modelo?
No necesariamente. Un estándar compartido de calidad y gobernanza importa más que un único modelo. Diferentes procesos pueden dirigirse a diferentes modos y modelos bajo reglas controladas.

Autor en Famulor